
阿里大模型再升级:Qwen4 启动训练,参数规模将达 5-10 万亿
核心进展速览
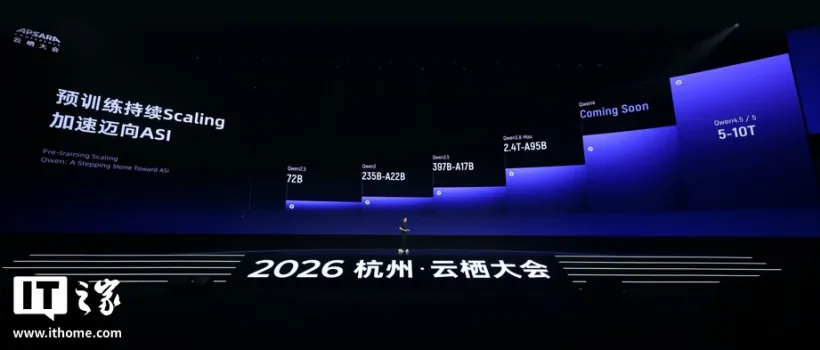
- 发布时间:Qwen4 已启动训练;全新下一代视频生成模型将于 2026 年 11 月正式发布
- 新版本与参数规模:Qwen4.5、Qwen5 等后续版本将扩展至 5-10T 参数(即 5-10 万亿参数)
- 推理模型:Qwen3.8-Max 和 Qwen3.8-Flash 已实装并完成优化,Qwen3.8-Flash 单实例推理吞吐量提升 96%
- 模型能力:Qwen3.8-Max 在 Artificial Analysis 得分达 45 分,与 Claude、GPT 最强模型同处第一阵营
- 部署进展:AI 手机全栈解决方案 Qwen Intelligence 已发布,专为终端场景深度优化
模型进化:从自我训练到芯片协同设计
阿里在本次云栖大会上系统展示了大模型递归自我改进(RSI)的落地成果。最引人注目的是 Qwen3.8-Max 实现人类“零参与”下的持续迭代:模型自主搭建训练流程、构造训练数据、设计实验并定位缺陷,在超一个月时间内完成 33 轮有效迭代。这一进展标志着大模型正从“人类主导训练”向“模型自主进化”过渡。
在推理层,Qwen3.8-Max 展现了强大的跨架构适配能力——在从未见过的平头哥新款 GPU 上,自主优化出下代架构的 Qwen3.8-Flash 新模型推理框架。这一操作无需人工干预即可完成,最终实现单实例推理吞吐量提升 96%。该数据存在显著反差:传统模型迁移新硬件通常需数周人工调优,而阿里此次实现近乎自动化且性能增幅近一倍。
芯片与模型协同设计方面,Qwen3.8-Max 仅基于一份真实总线模块规范,自主运行超过 60 小时、调用 EDA 工具超万次,完成物理实现全流程优化,最终将芯片面积减少 42%。这表明 RSI 技术已覆盖模型训练、推理部署到芯片设计的全链条。
视频与全模态:导演级生成能力即将上线
阿里下一代视频生成模型定于 11 月发布,定位为面向专业创作者的工具升级。该模型演进方向聚焦四大维度:
- 更长:长时序生成仍能保持画面与叙事一致性
- 更可控:创作者可精准设定人物、场景与镜头参数
- 更完整:从单镜头生成迈向理解完整叙事结构
- 更智能:模型具备导演级创作思维,支持分镜设计与叙事逻辑构建
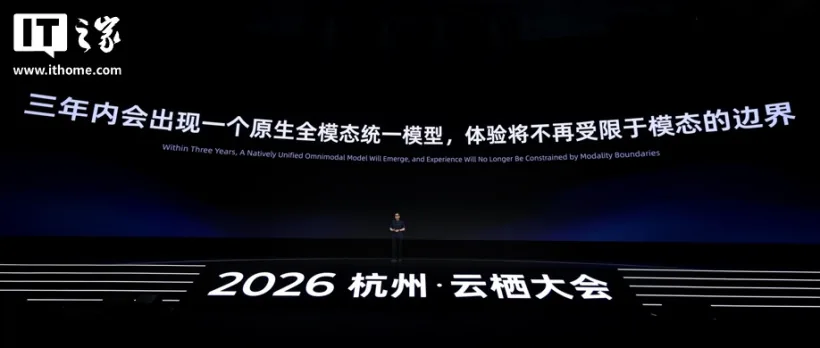
除视频模型外,阿里同日或近期还推出了视频生成模型、语音模型、图像模型、世界模型、音乐模型及全模态模型等多个新版本。阿里 ATH 技术副总裁、淘天集团首席科学家郑波预告:三年内将出现原生全模态统一模型,体验不再受限于模态边界。
终端落地:AI 手机方案已发布
阿里大模型加速向终端延伸。本次发布的 Qwen Intelligence 是面向手机场景的全栈解决方案,核心技术为 Agent 技术平台。该方案使手机可更可靠地完成跨应用的复杂任务流程,例如自主调取日历、规划路线、预订餐食等多步骤操作。目前该方案已面向合作伙伴开放接入。
| 模型版本 | 参数规模 | 主要能力 | 训练自主性 |
|---|---|---|---|
| Qwen3.8-Max | 未披露 | 人工零参与下完成 33 轮迭代,Artificial Analysis 得分 45 | 高度自主(RSI+后训练) |
| Qwen3.8-Flash | 未披露 | 单实例推理吞吐量提升 96%,适配平头哥新 GPU | 自主推理框架优化 |
| Qwen4 | 训练中 | 基于新一代架构,未知参数量 | RSI 进入训练环节 |
| Qwen4.5/Qwen5 | 5-10T | 未来版本,视频与多模态基础 | 扩展参数规模为主目标 |
落地建议
- 开发者/企业用户:若需高吞吐、低延迟推理服务,Qwen3.8-Flash 的 96% 吞吐提升值得关注,可优先测试平头哥 GPU 集成方案
- 创作者/内容团队:视频生成需求强烈的团队建议关注 11 月新模型发布,当前版本尚未满足长时序、导演级叙事控制要求
- 手机厂商/应用开发者:Qwen Intelligence 方案适合构建 Agent 类复杂任务流应用,建议并与阿里对接终端适配资源
写在最后
大模型已从“参数竞赛”迈入“系统协同”新阶段——当模型能自主设计物理芯片、优化推理框架时,研发效率的跃升远超单一参数增长所能实现。阿里 RSI 技术路径若持续演进,或将重塑大模型工程范式。