
核心事件:三款 LingBot-World 2.0 模型同步开源
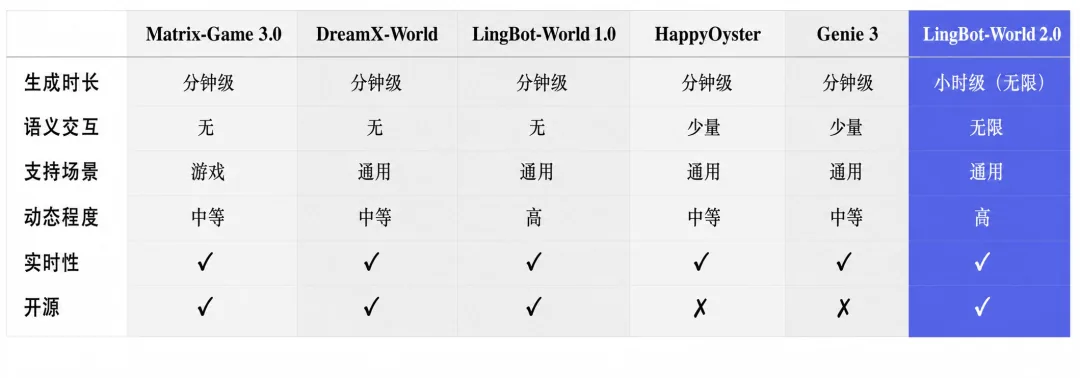
9 月 13 日,蚂蚁灵波科技正式开源全新一代实时交互世界模型 LingBot-World 2.0 系列,包含三款新模型:
- LingBot-World 2.0 Small(1.3B):面向消费级单卡 GPU 设计,参数量仅 13 亿,降低部署门槛
- LingBot-World 2.0 Bidirectional:集成混合双向注意力机制,提升编辑与多模态理解能力
- LingBot-World 2.0 Causal Pretrain:采用因果预训练范式,抑制长时生成中的误差累积
此前已于 7 月开源 14B 全量版本,全体权重与推理代码已全面开放,采用非商用协议。开发者可通过 SGLang 框架开箱即用,同时支持 Reactor(PC)与灵光 APP(移动端)在线体验。
关键技术突破:长时稳定生成与高清实时交互
LingBot-World 2.0 的核心价值在于突破传统视频生成模型的两大瓶颈——短时漂移与高延迟响应。
传统世界模型生成视频通常仅能维持数秒至数分钟,误差随帧数累积导致画面崩坏。而本次开源的 14B 模型在长达一小时的不间断压力测试中画面锐利如初,无明显画质衰减,成为目前唯一支持小时级乃至无限生成的通用交互世界模型。
在交互响应方面,系统实现了 720p/60fps 的高清实时输出。这得益于三项关键技术组合:
- 因果预训练范式(Causal Pretraining Paradigm):从根源抑制复合误差
- 混合双向与自回归注意力掩码机制(MoBA):兼顾生成质量与稳定性
- 一致性蒸馏与分布匹配蒸馏(DMD):构建快速推理版本,降低采样成本
工程部署上引入编译器级 attention kernel 优化、混合并行推理、动态 KV 缓存调度与异步流媒体传输,实现“边生成、边解码、边显示”的低延迟流水线。
意外反差:1.3B 模型释放消费级部署潜力
值得特别注意的是,13 亿参数的 Small 版本与此前 140 亿参数的旗舰版同属二代系列,而非前代产品。这意味着 14B 模型可通过建模与蒸馏技术“压缩”出 1/10 大小的轻量版本——参数量级 dropping 达 10 倍,却共享相同交互能力基础架构。这为单卡消费级 GPU 用户提供了此前仅限高端集群的实时世界模拟能力。
相关能力对比详见下表:
| 模型版本 | 参数量 | 适配硬件 | 架构特点 | 适合场景 |
|---|---|---|---|---|
| LingBot-World 2.0 Small | 1.3B | 消费级单卡 GPU | 因果预训练蒸馏版 | 本地快速部署、轻量化实验 |
| LingBot-World 2.0 Bidirectional | 未披露 | 中高端GPU | 混合双向注意力掩码 | 编辑操控、多模态理解 |
| LingBot-World 2.0 Causal Pretrain | 未披露 | 多卡/集群 | 因果预训练范式 | 长时演化仿真 |
| LingBot-World 2.0 (14B) | 14B | 高算力集群 | 全量架构 + MoBA | 研究验证、复杂世界构建 |
应用落地建议
对于 شخص的使用者,若已有中端显卡(如 RTX 4070 级别及以上)并希望本地测试实时世界生成,1.3B Small 版本是首选入口;研究团队若需构建多人交互或复杂事件驱动系统,则建议采用 14B 全量版结合directorAgent 模块。
建议再等等的场景包括:
- 仅需生成秒级短视频片段的用户——可等待上游视频模型迭代;
- 对 4K/120fps 有硬性需求的商业项目——当前公开规格仅到 720p/60fps。
写在最后
LingBot-World 2.0 将交互世界模型的可用性门槛从“专业实验室专属”推向“开发者可触达”,其轻量版与全量版协同开源的策略,为具身智能、游戏开发与自动驾驶仿真提供了真正的端到端开源基座。当世界模型开始以“小时”而非“分钟”为单位稳定运行,AI 原生交互体验的边界正在被技术重构。
(信息补充:因果预训练指训练过程中仅利用历史帧预测未来帧,类似语言模型的 autoregressive 机制;混合双向注意力掩码(MoBA)是在长序列自回归中局部嵌入双向注意力以缓解信息衰减的技术手段。)