
核心事件
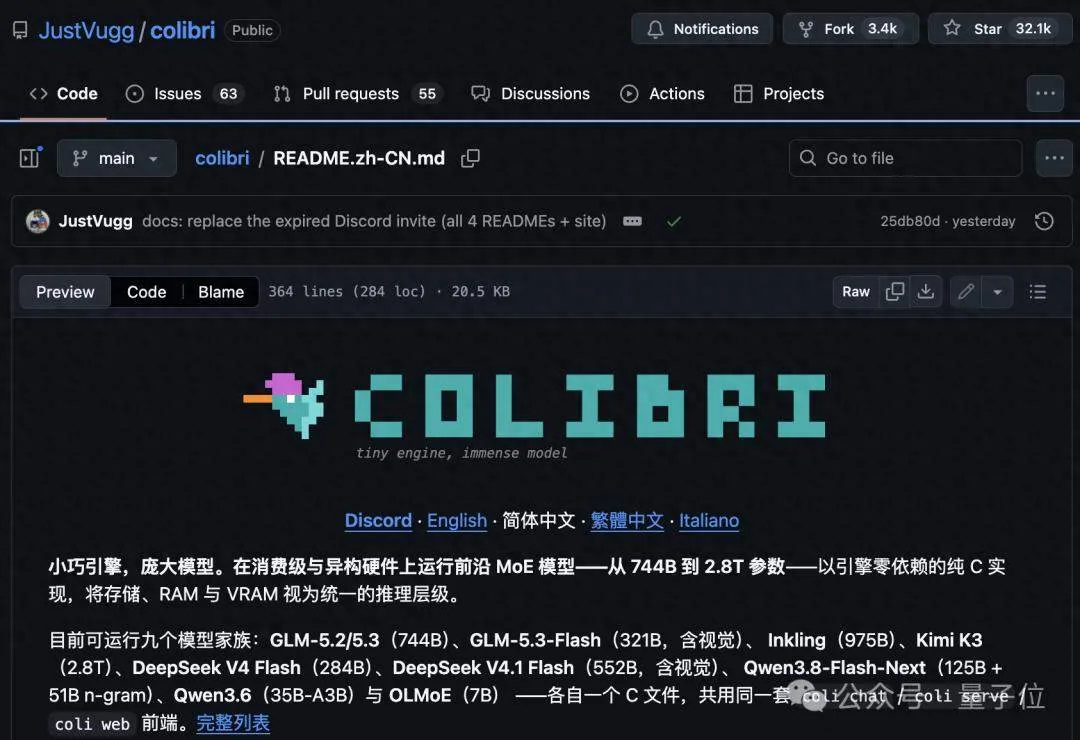
GitHub 开源项目 Colibrì 于近期爆火,截至报道时已获 32k Star,其核心能力是在无 GPU 的普通笔记本上运行超大规模稀疏专家模型(MoE)。项目由开发者 JustVugg 独立开发,不依赖任何深度学习引擎。
- 发布状态:已开源,提供 Linux/macOS/Windows 预编译版本
- 模型支持:覆盖 9 个模型家族,含 GLM-5.2/5.3、DeepSeek V4 Flash、Qwen、Inkling、Kimi K3 等
- 权重精度:统一采用 int4 量化
- 最低硬件门槛:GLM-5.2 仅需 16GB RAM(推荐 24GB),128GB RAM 机型可达约 1.8 token/s
- 是否开放权重:仅提供推理框架,模型需用户自行获取并转换(项目提供转换工具链)
技术原理:分层推理与 JIT 式调度
Colibrì 的核心创新在于将模型推理与存储调度解耦,尤其适配 MoE 架构模型(如 GLM-5.2)。
MoE(Mixture of Experts,专家混合)指模型虽总参数量巨大(如 744B),但每次 token 生成仅激活少量专家(约 40B)。Colibrì 将模型拆分为两部分:
- 常驻层:Attention、Embedding、共享专家等 Dense 组件,int4 后仅需约 9.9GB RAM
- 临时调用层:19456 个路由专家,int4 后约 370GB,全部存放于 NVMe SSD
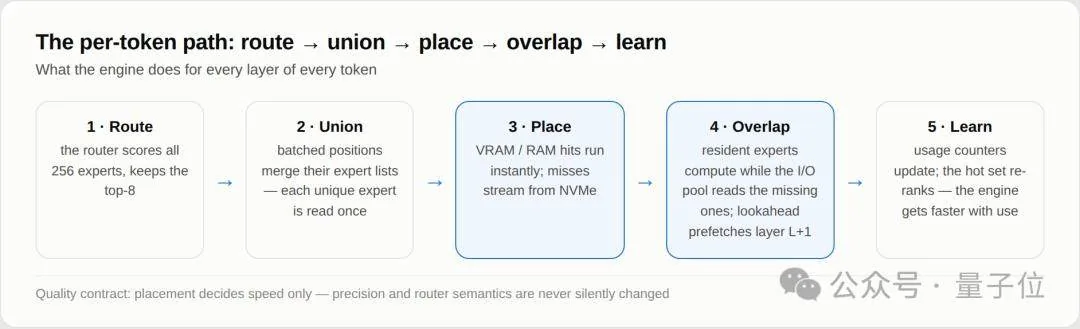
推理时 Router 首选判断需用专家,若未命中 RAM 缓存,则现场从 SSD 加载;计算完成后,根据热度决定是否保留专家在 RAM 中。开发者将此策略类比为“针对模型权重的 JIT(即时编译)机制”——仅在需要时加载热点权重。
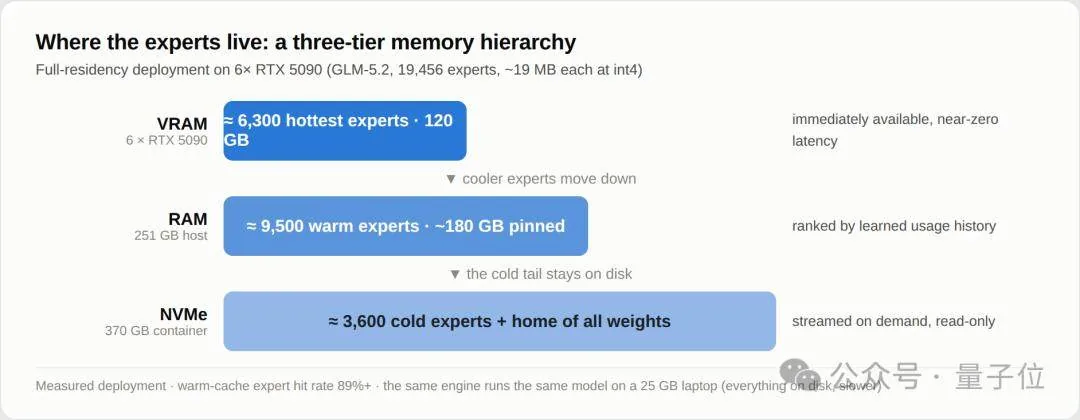
为提升 I/O 效率,Colibrì 构建了 VRAM / RAM / NVMe SSD 三级分层调度系统:
- 热门专家驻留 RAM 或 VRAM,避免重复硬盘读取
- 采用 LRU 缓存策略 + 使用频次统计动态调整优先级
- 预测性预加载:基于相邻层专家路由的相关性(实测 71.6% 可预测性),当前层计算时后台提前读取下一层可能专家
- 多盘并行:支持在两块 SSD 中存放模型副本,分摊 I/O 压力
关键性能数据与模型覆盖
Colibrì 持续拓展模型支持谱系,不同规模模型的资源需求出现显著反差:
| 模型(int4量化后) | 总参数量 | 激活参数量 | 硬盘存储需求 | RAM 起步 | GPU 是否必需 |
|---|---|---|---|---|---|
| GLM-5.2 | 744B | ~40B/token | ~372GB | 16GB(推荐 24GB) | 否 |
| Kimi K3 | 2.8T | 104B | ~1.6TB | 32GB | 否 |
注:DeepSeek V4 Flash、Inkling 等模型的具体激活参数与硬件需求因原始资料未详述,暂无法提供数值。
意外反差点:GLM-5.2 在纯 CPU 机器(12 核 + 25GB RAM)冷缓存初速仅 0.05–0.1 token/s,但经过缓存热身与多级调度优化后,仅靠软件策略即可接近 5.8–6.8 token/s(6 张 RTX 5090 高速场景),证明调度策略本身贡献了数个数量级的性能提升。
实用建议
- 适合立即尝试者:具备 24GB+ RAM 的笔记本用户,希望体验 GLM-5.2/5.3 或 Qwen 系列模型,且不追求高吞吐;偏好开源、零引擎依赖的技术实践者
- 建议再等等者:对推理速度敏感(>5 token/s)、硬盘空间不足 500GB,或仅拥有 8–16GB RAM 的用户,当前阶段体验可能受限
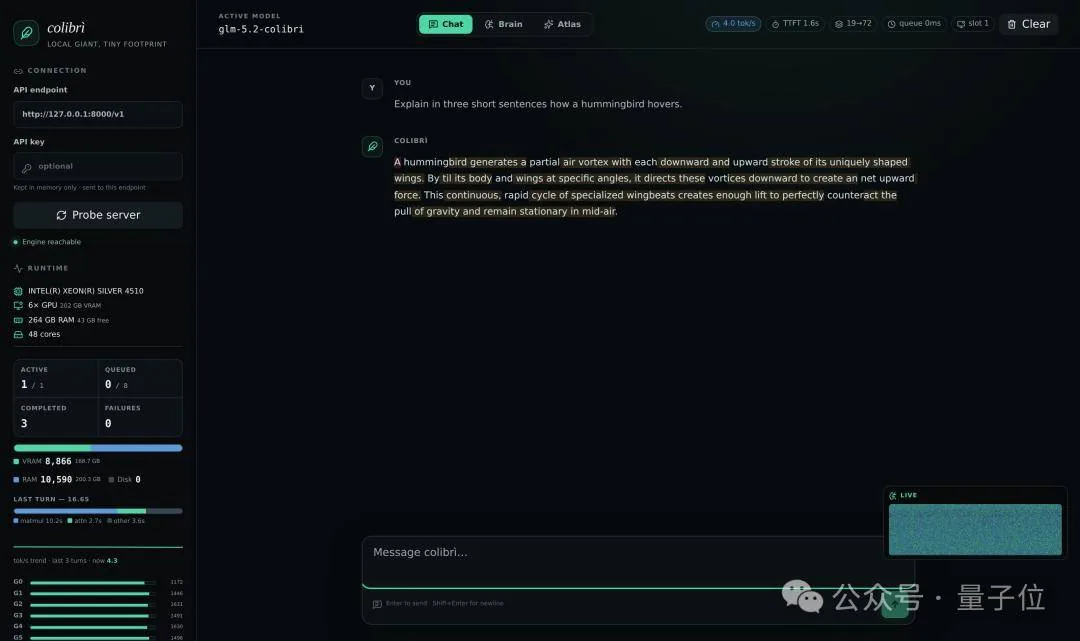
- 实操提示:项目提供 Web Dashboard 和“Brain”可视化页面,可实时观测各专家内存位置与调用热力,降低调试门槛
写在最后
Colibrì 展示了大模型推理的另一种可能性:算力瓶颈正从硬件规格转向算法调度智能化。MoE 与分层存储结合的路径,为未来更低门槛的本地大模型部署提供了可落地的工程范式。