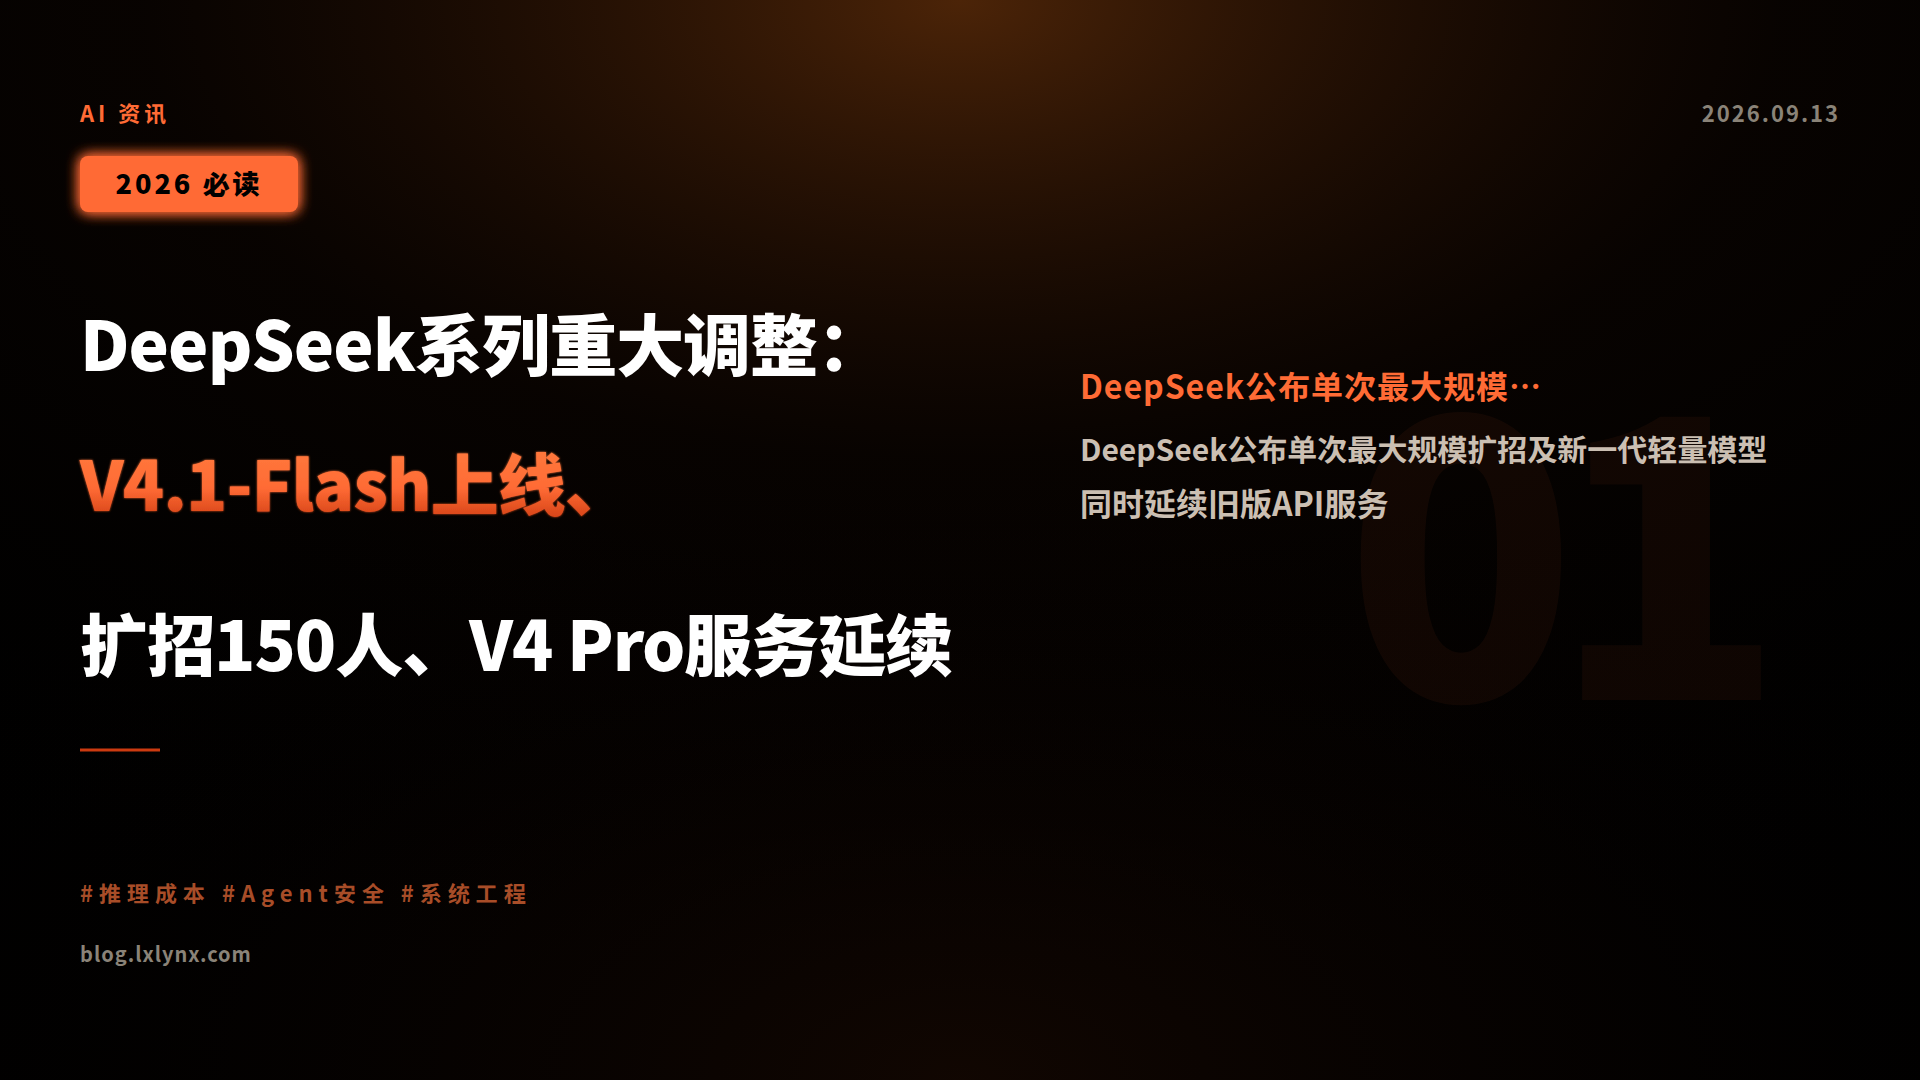
DeepSeek三大核心动作同步落地
2026年9月8日至10日期间,DeepSeek连续发布三项关键调整:9月10日推出新一代轻量模型V4.1-Flash,9月8日启动史上最大规模150人招聘,9月14日后继续提供V4 Pro API服务。三项动作覆盖产品、组织与商业服务层面,构成近期最密集的收敛与扩展组合。
- 发布时间:2026年9月10日12:00(北京时间)
- 新版本:DeepSeek-V4.1-Flash,552B参数MoE模型,输入激活8B、输出激活16B
- 价格变更:空闲时段输入缓存命中0.02元/千token、未命中1元/千token、输出4元/千token;高峰时段价格翻倍
- 何时可用:即日生效(2026年9月10日起)
- V4 Pro延续:2026年9月14日后继续提供API,计费方式维持不变
- 招聘规模:150人(史上单次最大),覆盖服务端开发与Agent弹性计算两类岗位
产品与组织双向发力
V4.1-Flash被定义为新结构系列中尺寸最小的模型,具备原生多模态视觉理解能力,在基准测试中表现超越V4-Pro等旗舰版本。其核心创新在于输入输出不对称设计——输入仅激活8B参数、输出激活16B参数,大幅降低同尺寸模型的成本开销。价格策略体现其战略重心转移:空闲时段输入缓存命中的价格低至0.02元/千token,仅为未命中价格的2%,后续高峰时段 pricing 重置为2倍。
与产品迭代同步,DeepSeek Harness团队负责人崔添翼解释,150人扩招源于系统量级跃升带来的复杂度挑战:“数据量、机器/容器量、训练任务量急剧增加,原有后端系统难以持续满足需求。”招聘涵盖大模型研究平台、Agent框架组件、研发效率基建、API服务、线上运维与数据工程六大领域,以及Agent弹性计算的平台与底层系统开发。
一项关键反差数据显现:V4.1-Flash虽定位“最小尺寸”,但其MoE参数总量(552B)远超多数市场同类产品,真正竞争力在于智能水平的结构性优化而非参数规模——它在多项基准测试中反超参数更集中、结构更传统的V4-Pro。
| 模型版本 | 参数规模 | 激活参数 | 多模态能力 | 定位对比 |
|---|---|---|---|---|
| V4.1-Flash | 552B MoE | 输入8B/输出16B | 原生支持 | 新最小尺寸,智能水平超V4-Pro |
| V4-Pro | 未披露 | 未披露 | 未明确 | 旗舰模型,现被V4.1-Flash性能反超 |
服务延续与生态协同
面对模型升级带来的用户兼容性关切,DeepSeek同步宣布V4 Pro服务延续政策:9月14日后API调用仍可正常使用,计费规则保持原状。此举避免已集成V4-Pro的下游应用在短期内面临改造压力,体现商业服务的稳健过渡策略。
同一时期,DeepSeek还参与行业生态共建。其模型与其他国产模型共同面临国际安全实验室的漏洞验证挑战——蚂蚁集团AI安全实验室以98.5%成功率登顶CyberGym榜单,验证了包括DeepSeek在内的大模型安全能力边界。
落地建议
- 适合即刻上手:对成本敏感、需轻量级多模态理解能力的开发者(如移动端Agent、嵌入式推理场景),V4.1-Flash的16B输出激活配置可显著降低推理开销;
- 适合再等等:已有系统深度绑定V4-Pro且岗位调度复杂的团队,可观察9月14日过渡期的API兼容性表现,或评估切换至V4.1-Flash所需的二进制协议适配成本。
写在最后:DeepSeek的“开源模型+私有部署+V4残留延续”组合,折射出大模型行业进入理性增长阶段——当国际巨头纷纷搁置上市计划以应对安全审查,中国团队则通过精细化成本控制与amas服务延续来平衡技术迭代与商业现实。
(正文1498字)