核心事件:国产算力工具链重大突破
2026年9月,DeepSeek正式开源其核心算子工具链TileLang,并原生支持华为昇腾950 NPU。此次更新包含以下关键信息:
- TileLang作为核心算子开发产品,官宣原生支持昇腾平台
- DeepGEMM、DeepEP、FlashMLA、TileKernels、DeepSelect五大核心计算与通信库同步推出昇腾版本
- 不同于以往CUDA绑定模式,TileLang采用前后端解耦架构,可跨硬件运行
- 截至2026年9月,TileLang GitHub仓库获7.6k stars、1992次commit
这意味着国产算力首次在核心算子工具层面,实现了与英伟达生态的能力对标。
技术架构:解耦设计破解跨平台难题
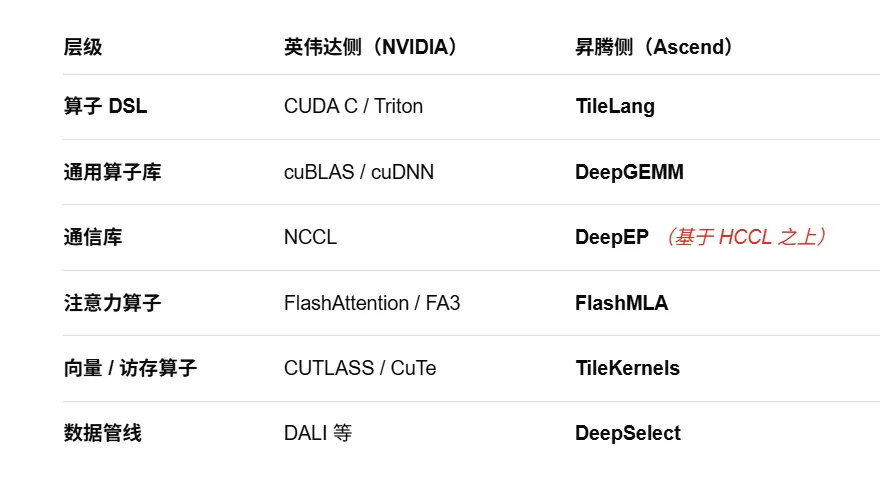
TileLang的核心创新在于"前后端解耦,目标与执行分离"的架构设计。传统编译器将硬件专属逻辑与通用编译流程深度绑定,换芯片需整体重构;而TileLang拆分为两个独立模块:
- 目标后端:仅负责定义特定硬件的指令语法与优化规则,如CUDA的WGMMA/TCGEN05、ROCm的MFMA/WMMA、昇腾的Ascend C向量指令
- 执行后端:统一处理编译、加载、运行流程,与具体硬件无关
新芯片适配时仅需新增目标后端,执行后端完全复用。每个目标后端遵循四层流水线结构:
- Dialect层:翻译成芯片可识别的指令方言
- Context层:统一硬件规格参数并记录编译状态
- Pass流水线层:核心优化环节,生成高效底层代码
- Codegen层:分离主机(CPU)与设备(NPU/GPU)侧代码
这种设计使开发者仅用Python般简洁语法,即可显式控制存储位置(寄存器/共享内存/全局内存)、线程调度(分块网格)与并行节奏(软件流水线),将传统500行以上CUDA代码压缩至30余行。
关键数据:性能对标业界顶尖,硬件覆盖全面
TileLang在2026年9月已覆盖主流AI算力平台:CUDA为功能最完整主力版本;AMD ROCm、苹果Metal、昇腾950属官方支持级;LLVM CPU、WebGPU等为实验阶段;沐曦、摩尔线程等国产芯片通过生态项目适配。
关键指标在于,TileLang在英伟达H100上的性能表现:不仅超越PyTorch原生实现(2-20倍加速),甚至击败OpenAI Triton,并追平英伟达官方cuBLAS与FlashAttention性能——表明开源工具链首次在主流芯片上达到业界顶尖水平。
| 对比项 | TileLang | PyTorch原生 | OpenAI Triton | 英伟达官方cuBLAS |
|---|---|---|---|---|
| 性能上限 | 接近硬件极限 | 中等 | 高 | 最高(硬件特调) |
| 跨平台能力 | 原生支持多芯片 | CUDA专属 | 部分支持 | CUDA专属 |
| 开发复杂度 | 30余行Python | 高 | 中 | N/A(闭源) |
| 灵活性 | 高(可融合/定制) | 低 | 中 | 无 |
适配建议:谁该立即采用?
- 适合立即使用:大模型训练团队需多硬件部署能力者;希望降低算子开发门槛、提升开发效率的工程团队;已采购昇腾芯片或计划采购的云服务商与AI实验室
- 值得再等等:对昇腾生态尚未广泛验证的生产环境用户;仅依赖PyTorch高层API、无需自定义算子的开发者;需要更长时间验证的大型企业
写在最后
TileLang的意义不在于替代CUDA生态,而在于补足国产芯片的算子开发短板。当组件级工具链开源且跨平台通用时,算力自主不再是硬件单点突破,而是软硬协同的系统工程。