
核心事件:多 Agent LLM 系统上线
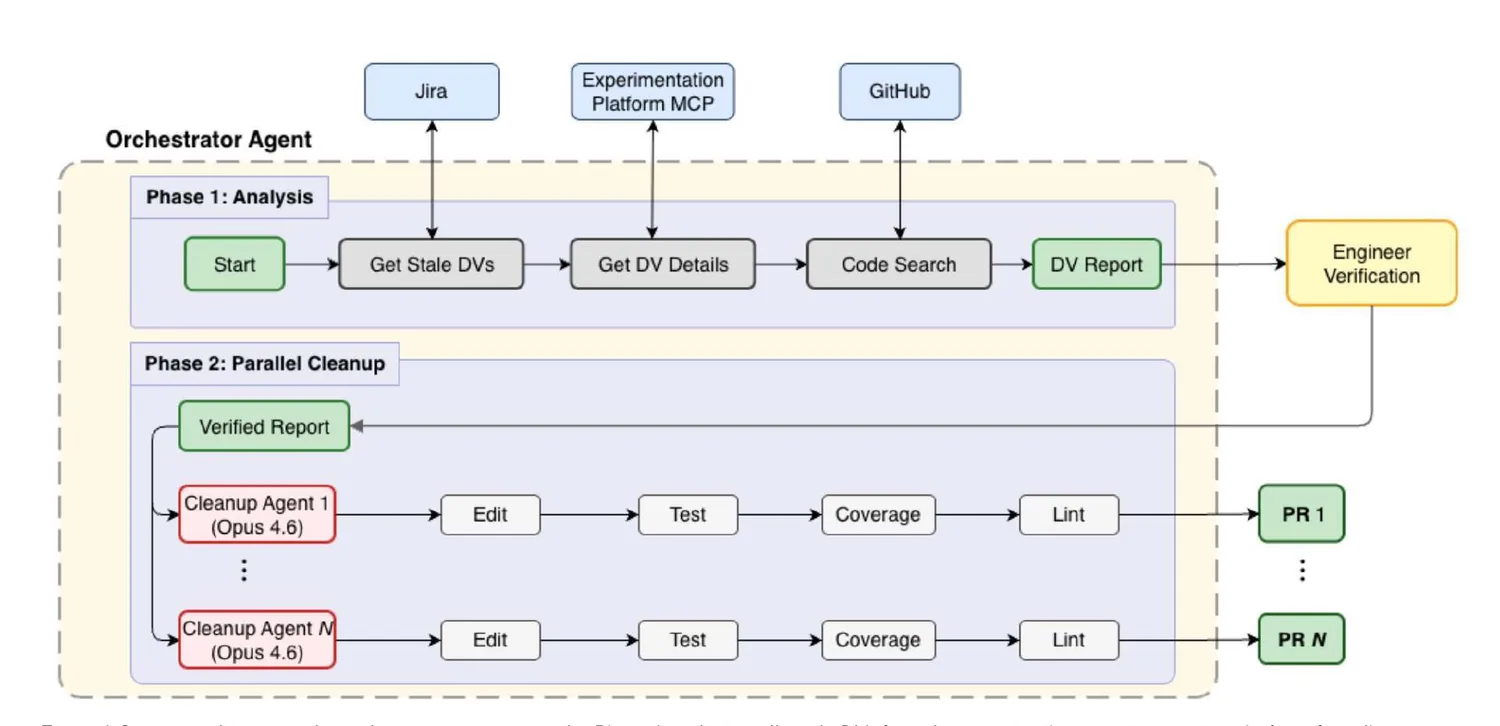
DoorDash 正式部署一套基于多 Agent 大语言模型(LLM)的自动化系统,用于清理其庞大代码库中过期的 Feature Flag(功能开关)。该系统已进入生产环境验证阶段,不涉及对外商业化发布,目前主要用于内部工程效率优化。
核心硬信息要点:
- 编排 Agent:采用 Claude Sonnet 模型驱动,负责信息汇总与任务协调
- 清理 Agent:采用 Claude Opus 模型驱动,负责代码修改与验证
- 运行环境:隔离的 Git Worktree,每个仓库最多并行 4 个 Agent
- 超时控制:单次清理任务超时时间为 1 小时
- 评估基准:针对 50 个过期 Flag 的实测结果(非生产全量覆盖)
技术架构与清理逻辑
DoorDash 的实验平台管理覆盖约 623 个代码仓库、6 万多个 Feature Flag,每月新增约 2,300 个。团队发现其中超过 1,000 个已过期——定义为:90 天内无修改、仍被代码引用、未归档/退役、且未被明确豁免的 Flag。
系统工作流分为两个阶段:
- 编排阶段:编排 Agent 通过 Google Agent Development Kit 构建,调用 Model Context Protocol (MCP) 查询实验平台,获取 Flag 的发布比例、目标值等元数据,并生成报告供工程师审批
- 清理阶段:清理 Agent 在隔离环境中定位所有引用(包括测试文件)、修改源码、执行构建与测试,并完成 JaCoCo 补丁覆盖率与 Detekt 静态分析校验,通过后自动生成 Pull Request
系统每日为识别出的 Flag 自动生成 Jira 工单,支持工程师在代码修改前介入审核。
关键数据与对比
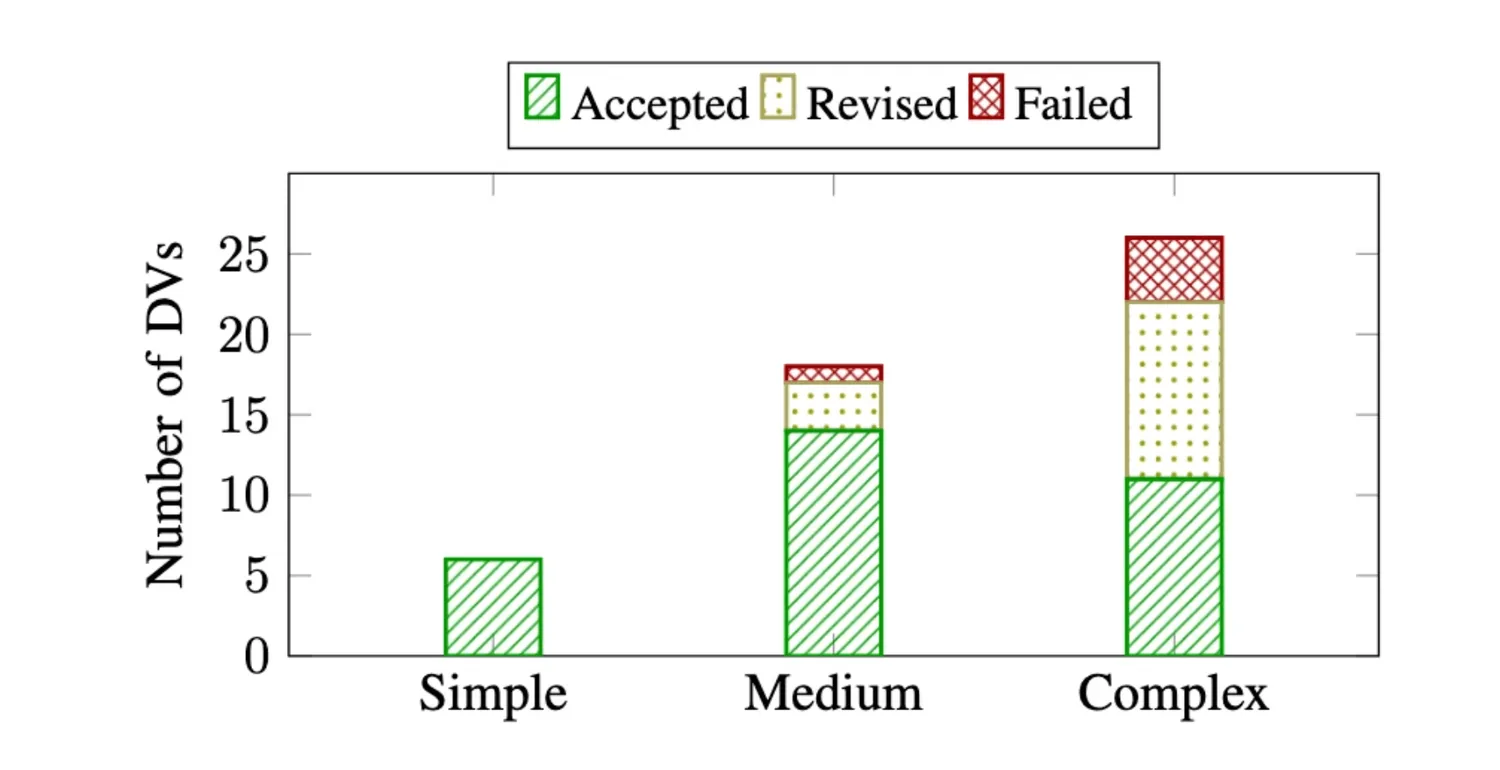
在 50 个采样 Flag 的评估中,系统表现如下:
| 指标 | 数值 | 备注 |
|---|---|---|
| 生成可用 PR 的比例 | 90% (45/50) | 5 个需进一步人工介入 |
| 平均清理耗时 | 13.8 分钟 | 对比人工 1–2 小时 |
| 单次清理成本 | 4.79 美元 | 基于评估样本估算 |
| 31 项一次性合并 | 即提交即合并 | 首次提交即被合并 |
| 14 项需修改后合并 | 需二次提交修正 | |
| 简单 Flag 成功率 | 100% | |
| 中等复杂度 Flag 成功率 | 94% | |
| 复杂 Flag 成功率 | 85% |
意外反差点:尽管Uber 开源的 Piranha 采用基于 AST(抽象语法树)的规则转换,但 DoorDash 发现该方法无法覆盖其依赖注入式 Wrapper 模式——Flag 与业务逻辑的关联属于语义层面,无法通过语法结构直接匹配识别。这构成了规则引擎与 LLM 两种范式的根本差异。
需人工介入的 5 个案例均涉及较深的调用链与跨接口参数传递,系统自身未产生任何 Bug 或回归问题。
工程落地建议
- 适合采用该方案的企业:月经性 Feature Flag 量级超 1,000 个、具备完整实验平台与自动化验证流水线(构建/测试/覆盖率/静态分析)的技术团队
- 建议再观望的企业:若依赖深度依赖注入或跨模块语义耦合严重、缺乏标准化 MCP 接入能力的项目,需评估模型理解语义关系的准确率与调试成本
作者注意到,系统采用 Gradle 禁用 Daemon 模式运行,以防止不同 Git Worktree 间状态共享——这是保障隔离环境可靠性的实用细节,适合同类自动化方案借鉴。
写在最后
DoorDash 的实践验证了 LLM 在代码重构场景中可实现“高成功率+低缺陷率”的平衡,其基于工程约束设计 Agent 行为边界(如超时与并行限制)的做法,为工业级 LLM 应用提供了可复用的方法论框架。该工作已被 ICSME 2026 Industry Track 收录。