
我之前做过一轮调研,结论是金融是 AI 应用渗透最深的行业之一。既然渗透深,说明数据基础好、玩家多、机会也可能多。这次我把问题拆成三个,用一套多代理深研管线跑了 97 分钟:金融行业需要实时追踪什么?哪些追踪和加工至今还是人工重复劳动?个人开发者或小团队能从哪切入?
先把方法论交代清楚,因为这篇里所有关键结论都经过三票对抗验证(三个独立核验代理各自尝试驳倒同一条结论,至少两票存活才算数),被驳倒的我也如实列出。共 114 个子代理、1,752 次工具调用,所有厂商定价均为 2026-09-16 当日快照。
一、金融行业在追踪什么,数据从哪来
追踪对象可以归成五类:公告与披露(财报、招股书、股东增减持、限售解禁)、监管动作(处罚、纪律处分、问询函)、持仓与交易动向(基金持仓、内幕交易、13F)、评级与观点(分析师评级、业绩会记录)、舆情与信用风险。每类的数据源在中国和海外是两套完全不同的格局。
中国市场:官方渠道比想象中开放,但加工层已被占住。
公告的权威源是巨潮资讯网(cninfo.com.cn)——证监会指定、深交所全资子公司深圳证券信息有限公司运营,覆盖沪深京三市加港股镜像、基金、债券。关键情报是它的官方 API 平台深证信数据服务平台(webapi.cninfo.com.cn):公告查询接口实测可用(我这次深研里 9 月上半月港股公告拉到 7,694 条、深市 4,256 条),注册 token 即可调用,不必爬网页。
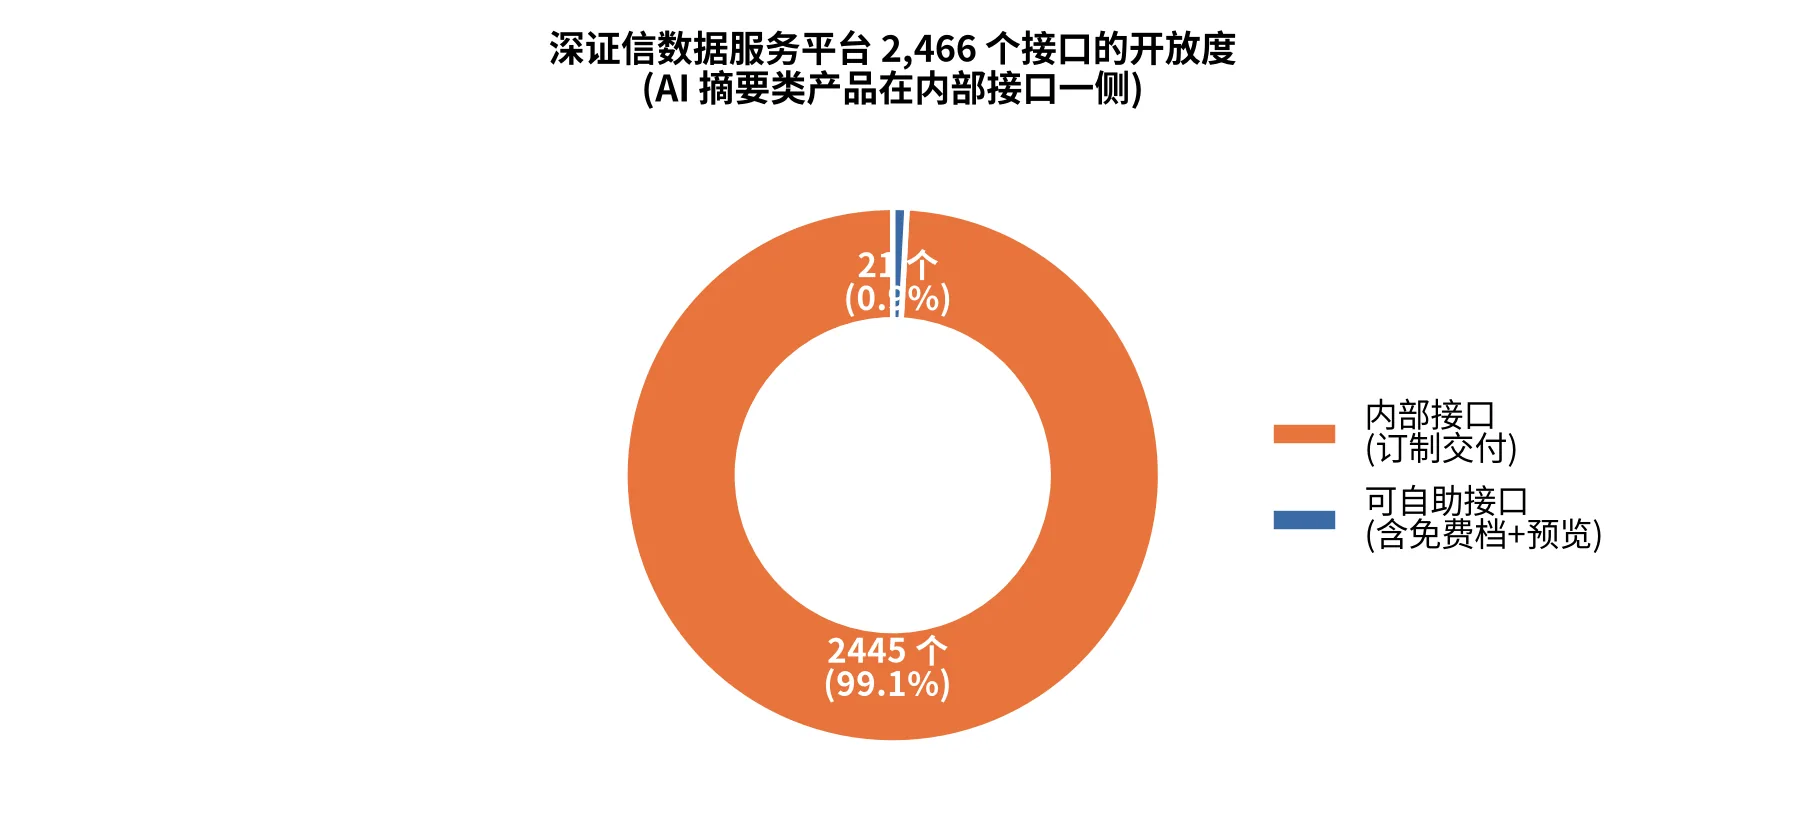
深证信本身就是一个 API 商城,2,466 个接口里已经有「股票智能摘要」「公告全文抽取」这类 AI 加工产物——但注意,2,466 个接口里 2,445 个标记为「内部接口」,智能摘要类产品走订制交付而非自助购买。也就是说,「公告→AI 摘要」在中国不是空白,而是官方已经商业化了,个人能自助买到的口径比目录显示的小得多。
一站式商业源是东方财富 Choice(quantapi.eastmoney.com,Python/MATLAB/R/C++/C#/Java 全套 SDK)。真正让我收起「舆情监控创业」念头的是:Choice 的舆情预警监测已经产品化——覆盖 200 万+企业、企业—集团—关联方三级穿透、多通道自动推送、联动信用评级和兑付进展。通用舆情监控这条赛道,巨头已经做完了。
监管侧反而是个痛点:上交所把监管措施分散在上市公司监管动态、发行上市审核、债券监管、交易监管、会员监管五个以上独立栏目,官网没有统一的「处罚公示」入口。追踪中介机构追责(保荐代表人、签字会计师、签字律师的监管警示)只能人肉盯多个页面——这类信息持续高频产出(最新一条是 2026-09-09),分散结构本身就是聚合工具的真实需求来源。
海外市场:红海,但定价分层清晰。
SEC EDGAR 免费且权威,但两条硬门槛:全局 10 请求/秒限速(多台机器合并计算),User-Agent 必须声明公司信息(不声明直接 403)。这两条就是免费官方源和付费商业 API 的价值分界线。
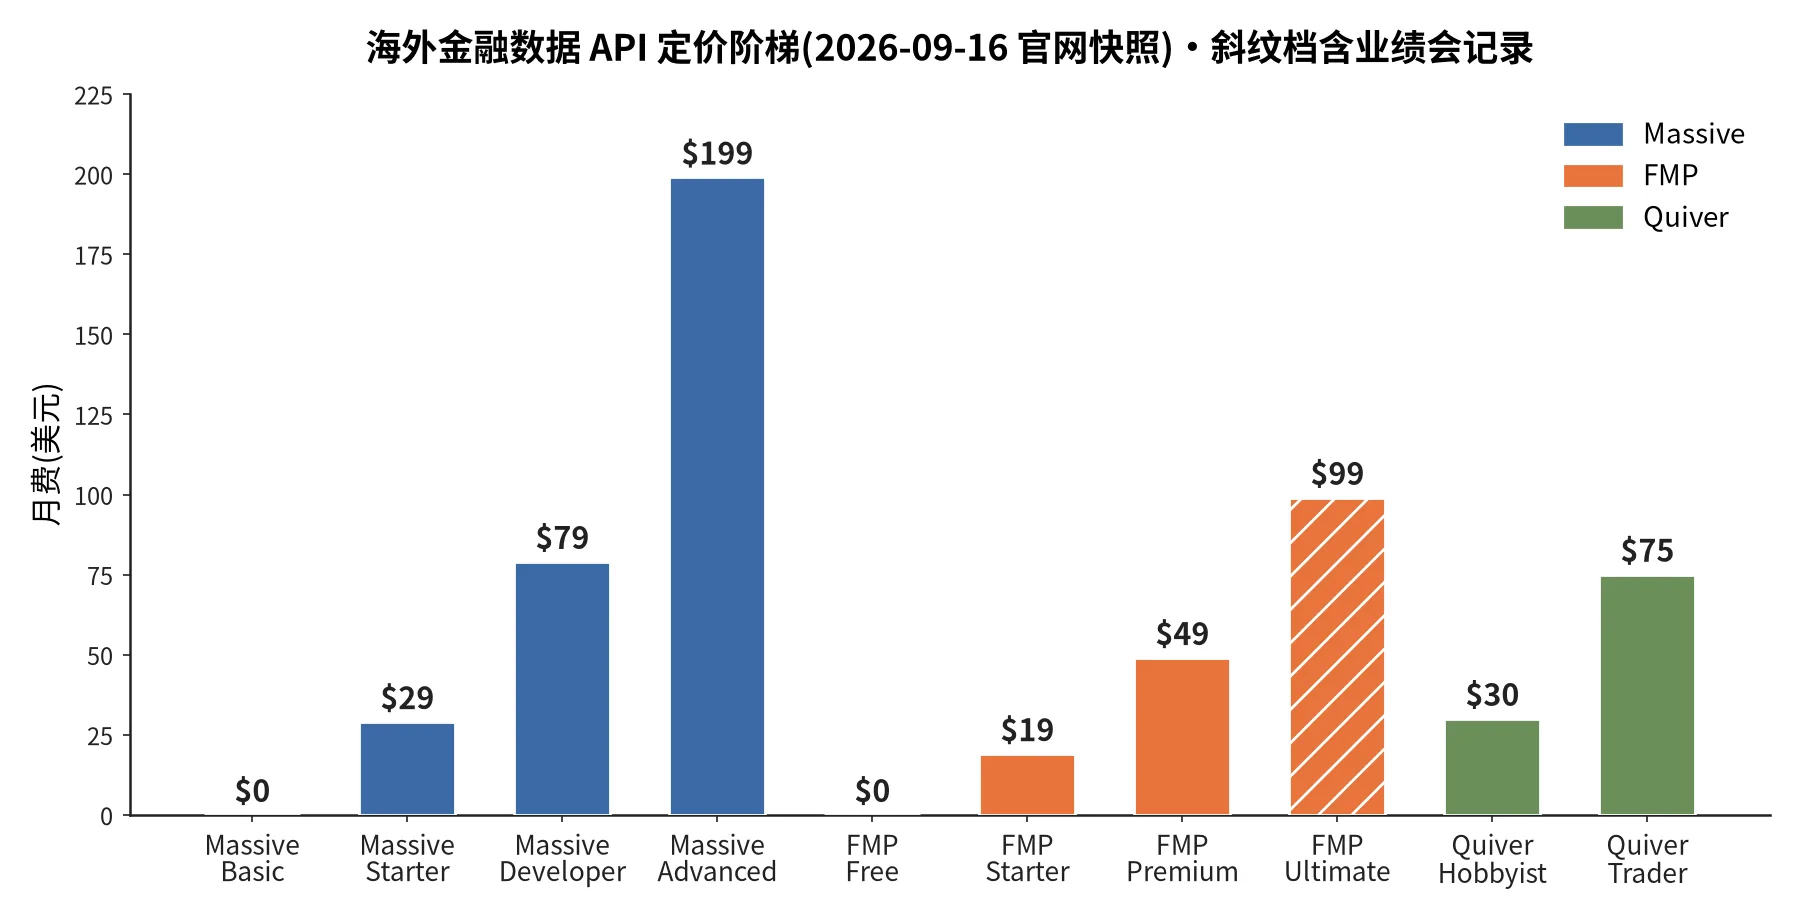
行情 API 端有个新闻级的情报:Polygon.io 已经改名成 Massive.com(全站 301 跳转,官方 SDK 自述 “formerly Polygon.io”)。个人档 $0 / $29 / $79 / $199 四档,付费档全部无限调用,差异在延迟和历史深度。
FMP(Financial Modeling Prep)把你能想到的追踪对象几乎全 API 化了:8-K、内幕交易、国会交易、13F 机构持仓、业绩会记录、分析师评级、新闻稿。免费档每天 250 次调用可以零成本验证。但业绩会记录(transcripts,覆盖 8,200 家公司、20 万+份全文)锁在 $99/月的 Ultimate 档——这条是 2-1 票通过的,厂商定价随时可能改。
另类数据端 Quiver Quantitative 用 15+ 数据集(国会交易、游说、政府合同、专利、高管薪酬)锚定了 $30-$75/月的个人档定价,商用另议。
二、哪些活还是人在重复干
先坦白:这一块的判断主要靠间接证据(官方栏目的分散结构、Choice 的自动化产品反推、机构工作流没有一手访谈),可信度天然低于第一部分。
能确认的人工重灾区有三个:
- 监管动作聚合。五个栏目分散、无统一入口,做风控或做媒体的人只能人工轮巡。这从上交所官网结构就能直接看出来。
- 长尾信息的人工盯守。巨头产品覆盖的是上市公司和发债人这类「核心名单」,200 万企业之外的长尾(比如地方金融办盯辖区小贷公司、垂直行业盯自己的供应链企业)大概率还是人工。
- 最终签核。机构里 AI 生成摘要、人工审核签发这个流程依然普遍——AI 干了初筛,人干判断。这意味着「AI 产出→人工把关」的协作工具层有空间,但纯全自动卖结论在国内机构侧推不动。
三、个人开发者可以从哪切入
结合竞品密度和空白点,我自己的排序是:
机会一:监管处罚聚合管线(中国,空白最确定)。 证监会处罚库、上交所/深交所纪律处分、NFRA 罚单、中基协 AMAC 处分,全部分散且无聚合产品。做成「监管雷达」日更推送,卖订阅。风险:本次深研证实上交所实际抓取难度高于表面判断(详见下文被驳倒清单),动手前必须逐站实测反爬;以及合规天花板未知(见机会四)。
机会二:垂直行业舆情监控(差异化唯一出路)。 通用监控被 Choice 做完了,但「只盯某个垂直行业、行业术语识别准、推送给不看 Wind 的中小客户」还有缝隙。本质是做巨头的长尾补集。
机会三:海外垂直聚合与加工层。 数据 API 本身是红海(FMP/Massive/Quiver 分层清晰),但「EDGAR 免费源 + AI 摘要 + 垂直场景」的组合还有空间——比如只服务某类投资者、只加工某一类文件。数据成本起点 $0(EDGAR)到 $29/月(Massive Starter)。
机会四(其实是雷区):合规。 向客户提供 A 股/港股数据是否需要数据商备案或持牌?转售 Choice/深证信数据的授权边界在哪?这两问本次深研没有拿到可靠答案(Grok 对合规话题拒答,一手源也没查到明确规定)。我的态度:在中国做面向公众的金融数据产品之前,这个问题必须先花法律咨询费搞清楚,它直接决定上面三个机会的可行性排序。海外厂商普遍区分个人/商用授权,转售边界也要逐家确认。
四、被对抗验证驳倒的说法(如实披露)
这套深研最值钱的部分往往是「什么被证伪了」:
- 「上交所监管栏目是服务端渲染 HTML、无 JS 即可抓取、爬虫难度低」——0 票对 3 票被驳倒。 实际抓取难度比表面高(反爬/动态渲染)。想做聚合管线的,实测先行,别信「官方栏目都好爬」。
- 「FMP 全家桶可低于 $100/月」——1 票对 2 票被驳倒。 transcripts 只在 $99/月 Ultimate 档且按年计费(约 $1,188/年),「百美元内配齐全家桶」不成立。
另有几个明确的未验证缺口:港交所披露易(hkexnews.hk)、证监会处罚库(csrc.gov.cn)、NFRA、中基协 AMAC 的结构化获取成本,以及中国 AI 研究助手竞品(问财、妙想的可信度较高,Wind「问数」、慧博智研未经官方页面核实)——这些是下一轮深研的题目。
尾声
这次跑下来我的整体感受:金融 AI 的「数据获取层」和「通用加工层」在两个市场都已被占满,真正的缝隙在聚合分散信息和垂直化加工这两层——恰好都是个人开发者的体力优势区。中国侧最大的不确定项不是技术,是合规;海外侧最大的成本项不是数据费,是想清楚垂直在哪。
完整研究过程(含全部来源链接与逐条验证记录)存了档,需要原始报告可以找我。