Google多智能体Scaling论文发布:架构适配优于盲目扩容
Google Research、Google DeepMind与MIT于2026年1月发布《Towards a Science of Scaling Agent Systems》论文最新版(arXiv v3),系统验证了多智能体系统在不同任务场景下的效能表现。研究覆盖260个严格受控配置,涉及6个真实Agent Benchmark、5种架构和3大模型家族,旨在将多智能体系统设计从工程直觉推向可量化科学。
核心发现:任务结构决定效能,协调税可能反超收益
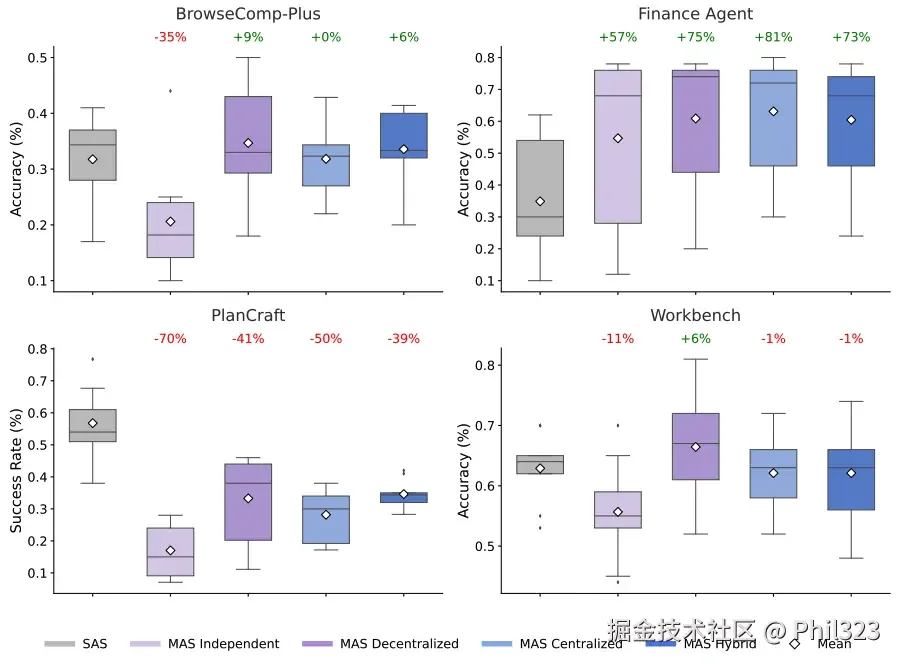
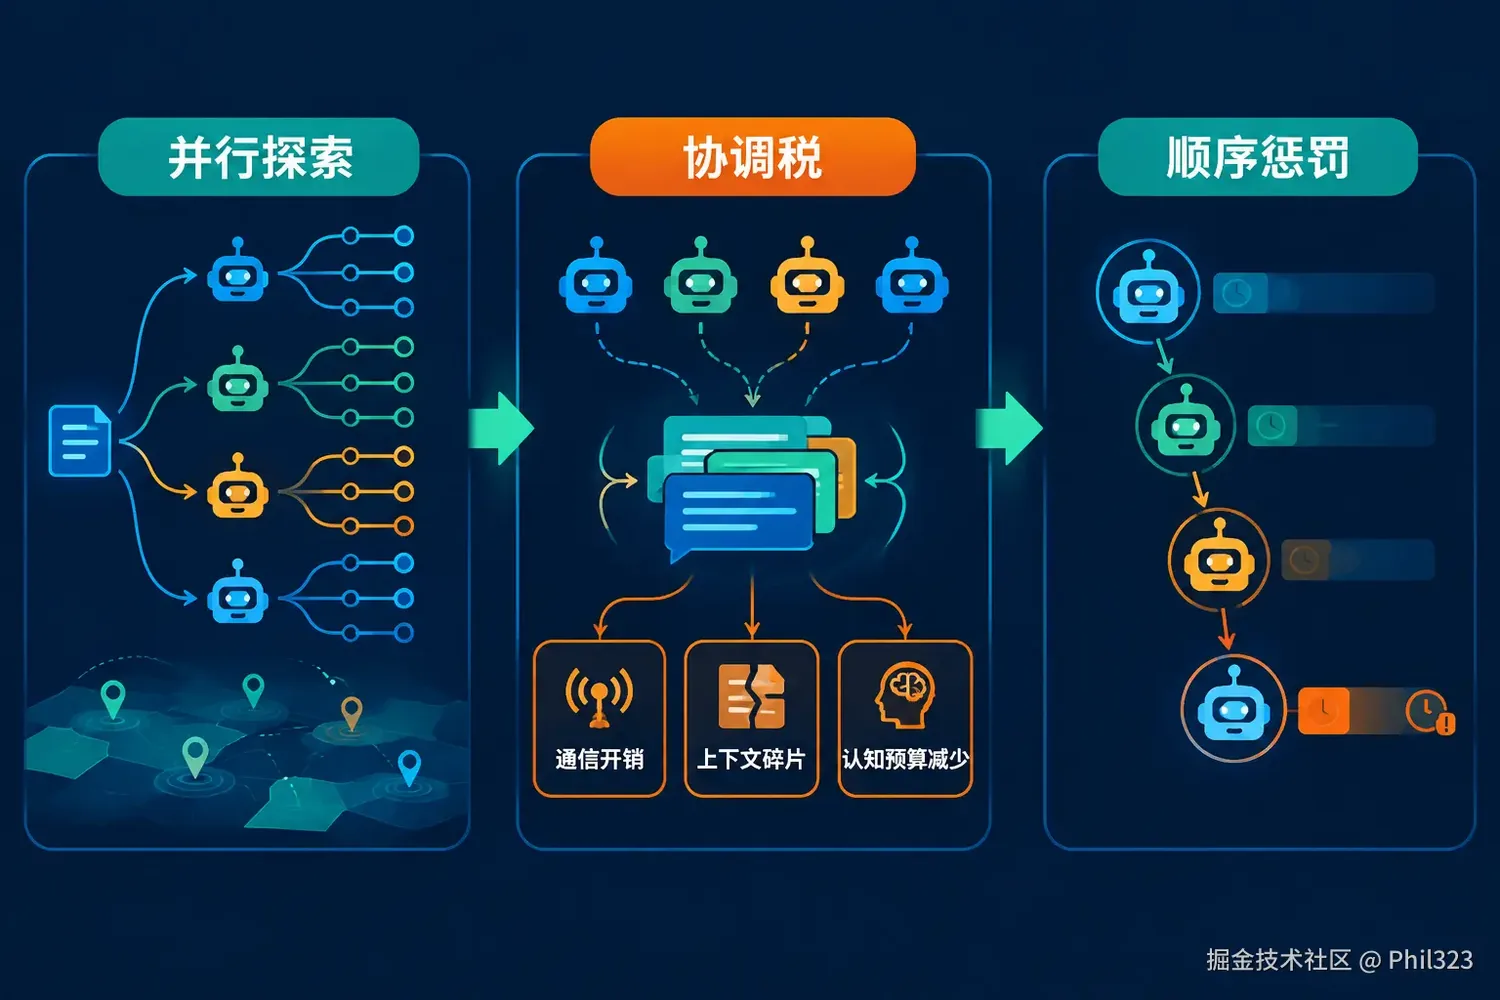
研究颠覆了"Agent越多越强"的常见直觉,指出决定效果的关键是任务可分解性、工具密度、单智能体基线和协调成本,而非Agent数量本身。实验数据显示:
- Finance-Agent任务:中心化架构提升80.8%,因金融分析可自然并行拆解为监管、财报、运营等独立子流;
- PlanCraft任务:所有多智能体架构均下降39%~70%,因任务严格顺序依赖,硬拆并行反而割裂状态与推理链;
- SWE-bench Verified:单智能体基线已达52.2%,多智能体全部下降,边际收益趋零;
- Workbench:16个工具下多智能体效果基本持平,工具密集反而加重协调税。
这一反差揭示:多智能体并非通用增强方案,而是条件性技术。六个Benchmark聚合后平均仅微降0.3%,但95%置信区间跨度达150个百分点(-58.7%~+77.2%),印证"架构错配可完全抵消模型升级"的观察。
五种架构成本对比:中心化在错误控制上更优
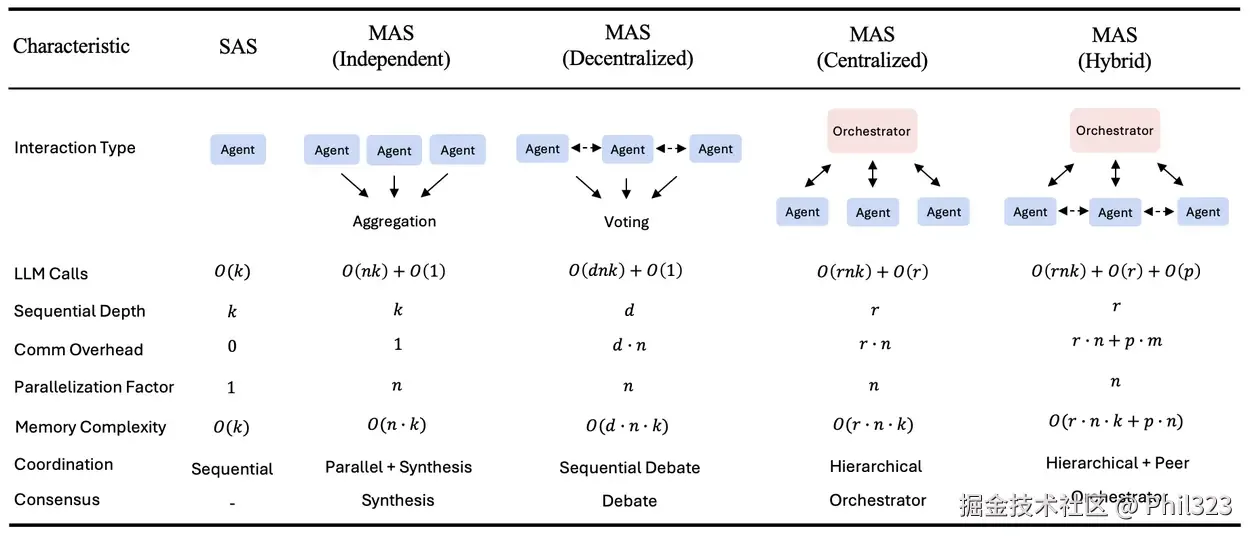
论文定义了五种典型架构并量化其协调成本:
| 架构 | 金融分析提升 | PlanCraft变化 | 错误放大倍数 | 平均效率(SAS基准) |
|---|---|---|---|---|
| Single-Agent | - | - | 1.0x | 100% |
| Independent | -35% | -70% | 17.2x | ? |
| Centralized | +80.8% | -39% | 4.4x | ? |
| Decentralized | +9.2% | -28% | 2.1x | ~28% |
| Hybrid | +15.3% | -42% | 5.8x | 16% |
- Independent:仅结果聚合无过程验证, trace级错误放大达17.2倍,是最危险架构之一;
- Centralized:Orchestrator作为验证瓶颈,将错误放大压至4.4倍,在金融分析中表现最佳;
- Decentralized:成功率0.477最高,但效率仅SAS的28%,适合高熵搜索场景;
- Hybrid:平均协调开销达515%,每次任务44.3回合(SAS为7.2),结构复杂但无显著优势。
实验证明:超过3~4个Agent后,固定Token预算下每个Agent的推理质量明显受压;超线性增长模型为Turns = 2.72 × (n + 0.5)^1.724,R²=0.974。
实践选型建议:先跑单智能体基线,再评估架构
研究提出可执行的五步决策框架:
- 任务可分解性检测:能否自然拆成并行子问题?
- 基线达标性检查:单智能体成功率是否低于约45%?
- 工具密度评估:工具数多意味着更高协调成本;
- 错误容错需求:是否需要统一验证后再输出?
- 成本-收益测算:额外Token与延迟是否值得?
落地建议:
- 适合立即用多智能体:可并行金融分析、动态搜索、需要交叉验证的多源推理;
- 适合再等等:强顺序依赖任务(如多步合成流程)、单智能体已超45%成功率、工具调用频繁改变共享状态的场景;
- 成本优化提示:强执行者+较弱Orchestrator常优于反向组合,异构团队用去中心化比中心化更易见效。
写在最后
这篇论文标志着多智能体系统开始摆脱"试错式工程实践",进入基于可量化模型的设计阶段。其核心价值不在于否定多智能体,而在于提供了一套可验证的架构选型科学框架——在模型能力易得的时代,系统架构的匹配精度正成为真正的性能分水岭。