
华为2026全联接大会发布新一代AI算力底座
华为于2026年9月16日上海全联接大会(HCC)正式发布了一系列AI基础设施新品。核心成果包括:
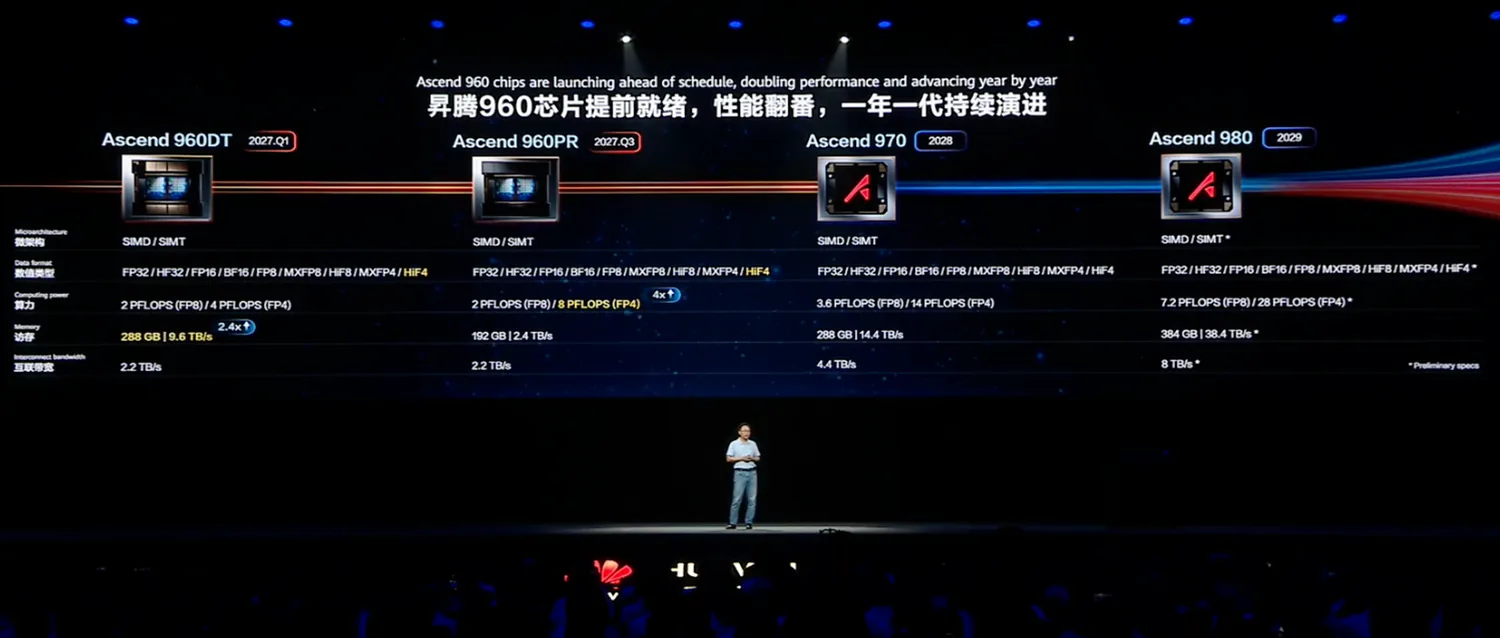
- 昇腾960DT芯片:支持2 PFLOPS(FP8)与4 PFLOPS(FP4)算力,研发进度超预期,提前至2027年一季度就绪
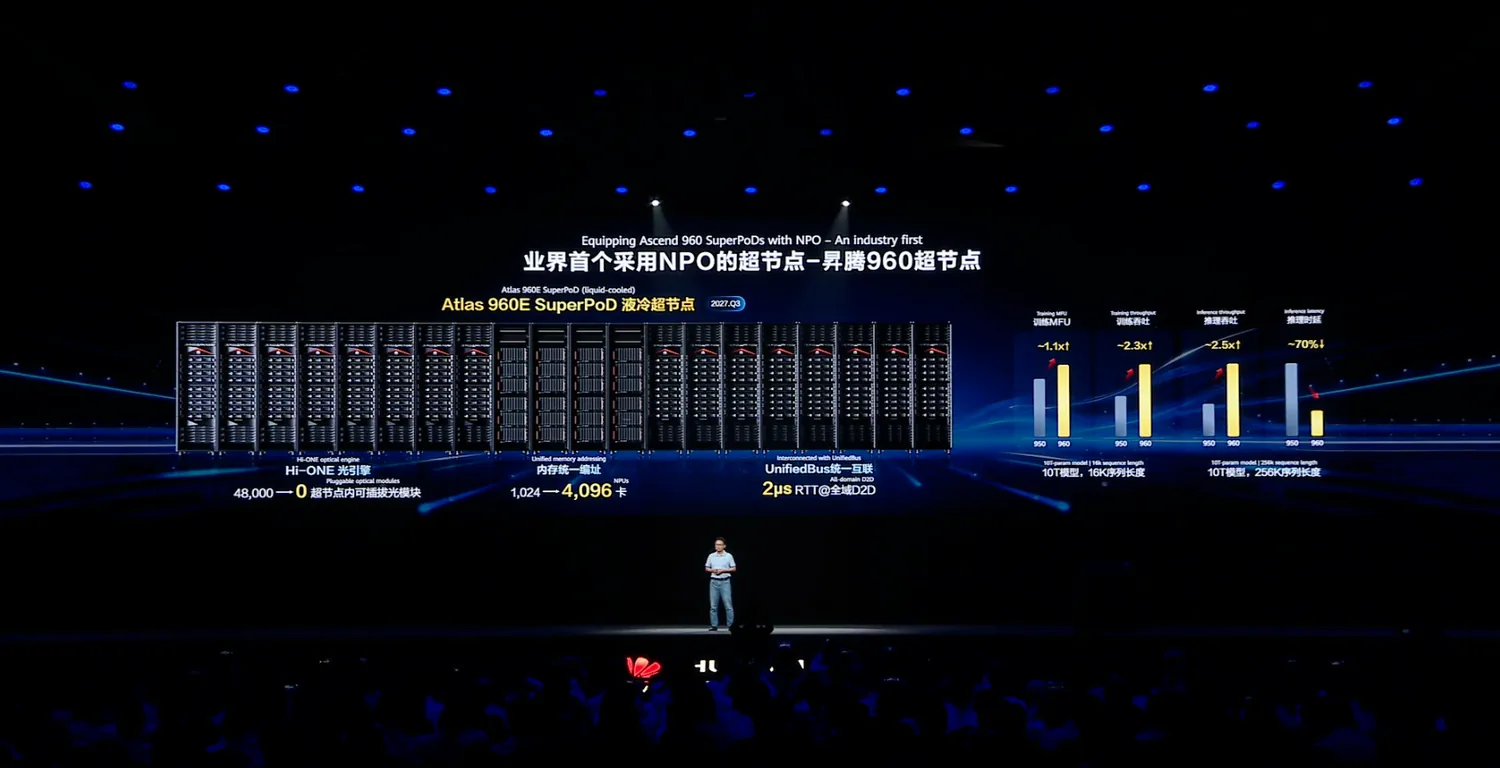
- 昇腾960超节点:全球首个采用NPO(近封装光学)技术的量产超节点,单节点支持4096卡,最大8 EFLOPS FP8算力
- 灵衢UnifiedBus协议:统一互联总线协议,已全面开放技术规范
- 鲲鹏950超节点升级:最大支持4096节点,形成256TB统一内存池
- OceanStor M900记忆存储:搭载灵衢总线,KV Cache时延降低超50%
- 灵衢全光交换设备:支持二层CLOS灵活组网架构
灵衢 UnifiedBus 是一套统一互联协议,旨在消除不同计算、存储、通信组件间的协议转换开销,让多节点集群如同单台计算机般高效协同工作。
11颗关键芯片构建超节点体系
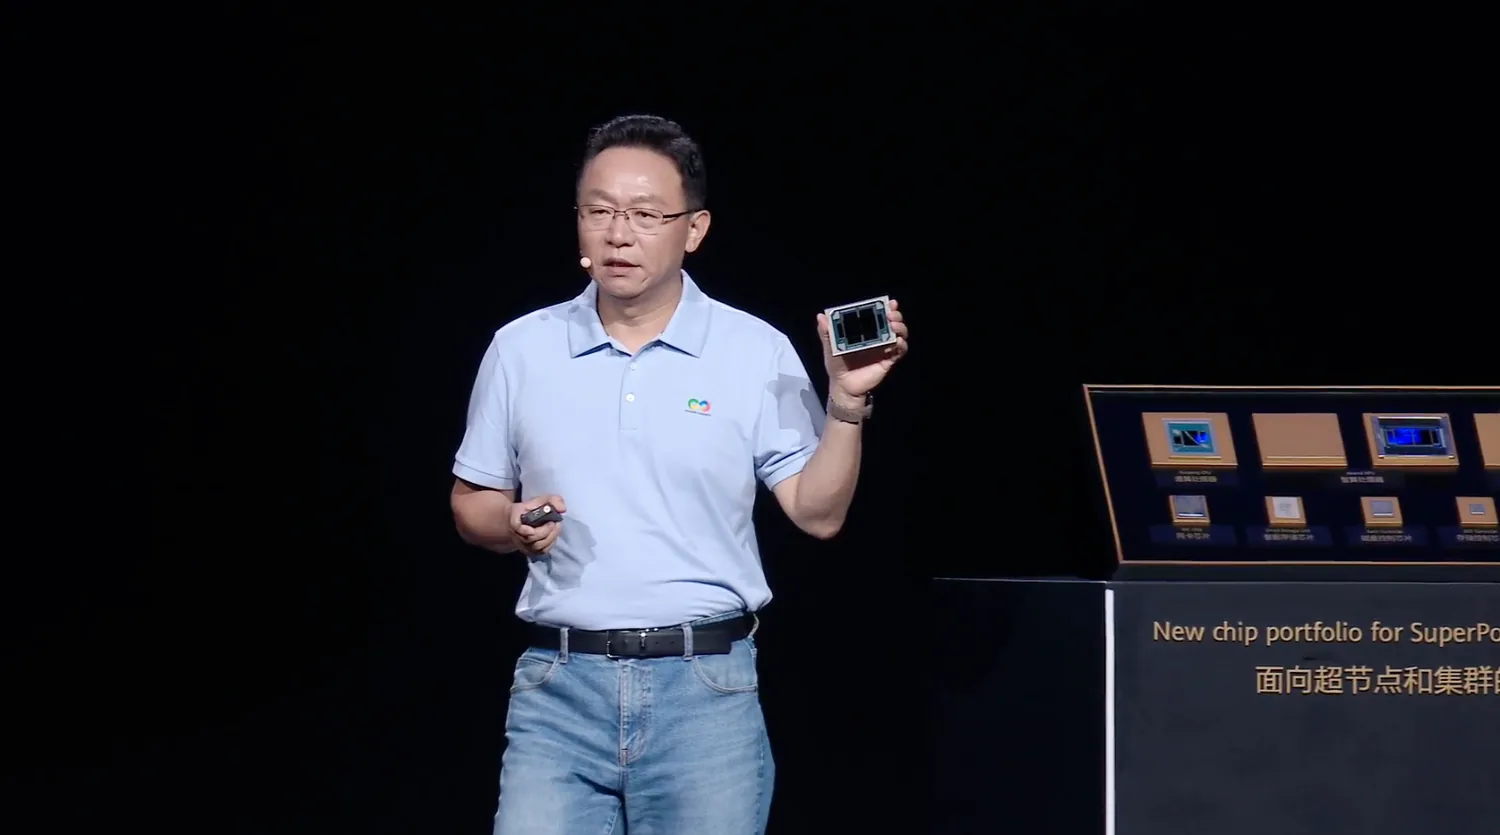
基于灵衢UnifiedBus架构,华为已打造超节点及超节点集群所需的11颗关键芯片,分为四类:
- 计算类:鲲鹏CPU与昇腾NPU,承担核心算力任务
- 互联类:涵盖Scale-out平面交换芯片、Scale-up平面低时延交换芯片及高速光互联芯片
- 存储类:包括介质控制器芯片与专为AI KV Cache设计的Smart Storage Unit
- 管理类:系统协调与管理功能套片
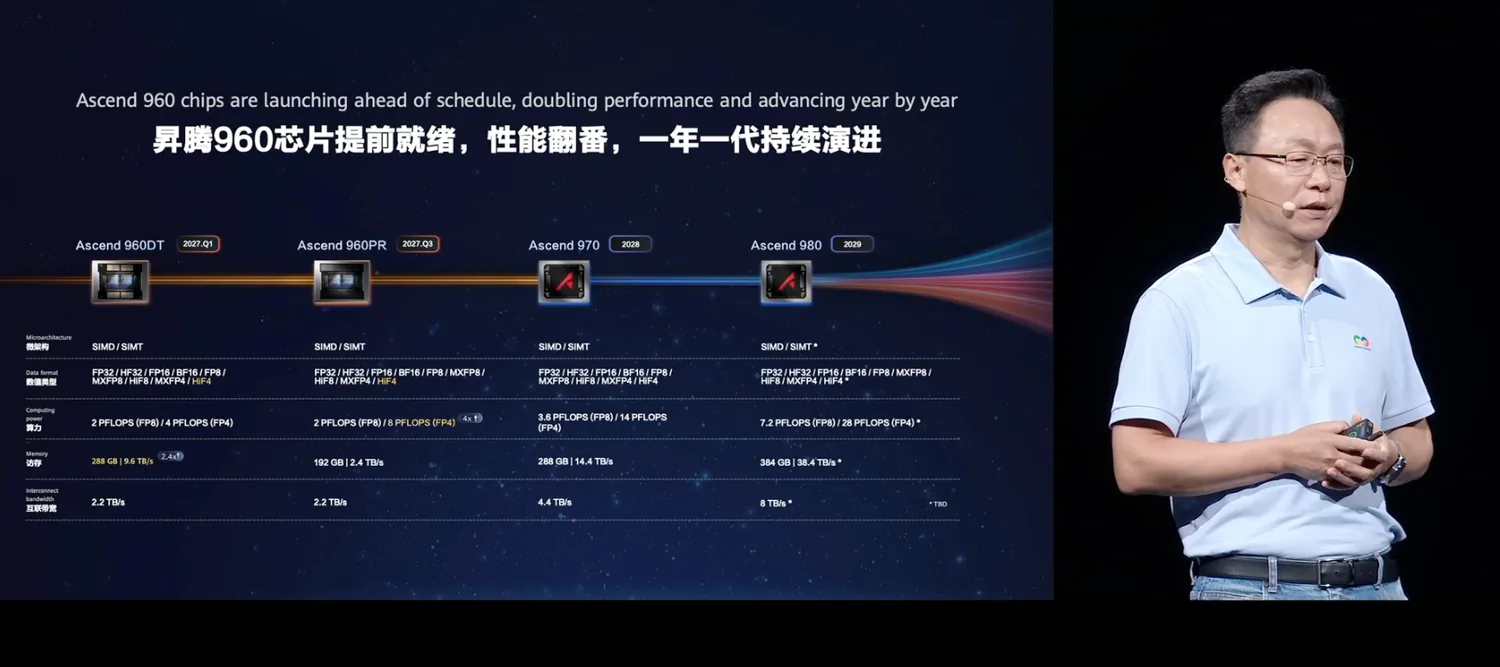
其中,昇腾960PR芯片进一步延续性能跃升,将支持8 PFLOPS FP4算力,预计2027年三季度提前一季度就绪。未来昇腾970与980芯片将于2028年与2029年依次推出,依托"韬定律"创新方向实现持续翻倍演进。
值得注意的是,昇腾910C超节点已完成超1000套部署,昇腾950超节点已进入规模商用阶段,表明其上代产品已形成实际商业验证闭环,为960系列量产铺平路径。
系统级架构创新:打破通信墙
大规模集群面临的核心挑战是通信开销导致模型浮点算力利用率(MFU)偏低。行业常规10万卡集群MFU通常仅20%左右,而基于灵衢UnifiedBus的方案可将MFU提升至35%。
为实现跨柜规模扩展,华为推出业界首个量产NPO光引擎Hi-ONE——7.2Tbps传输速率,内置光源设计兼顾高带宽、高可靠、低时延与低功耗。昇腾960超节点采用"灵衢UnifiedBus+Hi-ONE"组合,系统无故障运行时间提升1倍,可用度达99.8%。
存储层同样突破显著:OceanStor M900与L3.5层KV Cache直连,专用协议减少数据搬运次数至1次(传统PCIe+RoCE方案需5次),I/O时延与首token时延降幅均超50%,SSD读写寿命提升16倍。
鲲鹏超节点与端侧AI进展
通算(通用计算)超节点聚焦Agent场景优化。鲲鹏950升级后支持最大4096节点互联,统一内存池容量达256TB,10万级沙箱启动速度较传统方案提升30倍,沙箱密度提升25%;向量检索场景达30万TPS(transactions per second),实现性能倍增。
端侧AI方面,华为构建"麒麟+昇腾"自研算力组合、“盘古+三方模型"智能体系、HarmonyOS Agent OS底层重构与鸿蒙生态协同四大路径。Mate X2非凡大师已商用30B参数原生盘古MoE模型。开源鸿蒙生态规模超13亿,openEuler装机量突破2000万套,居中国服务器OS首位。
生态建设与算力供给模式
截至目前,华为鲲鹏生态全球开发者超416万,昇腾CANN社区月活开发者突破5000名,其中外部开发者占比61%,首次超过内部开发者。
昇腾NPU已接入PyTorch官方安装源,成为继英伟达、AMD、英特尔后全球第四个支持项。基于昇腾的原生训练模型超40个,覆盖90多个主流开源社区。
华为将通过两大核心能力满足多元需求:算力基础设施(硬件变现) 与云服务(灵活供给) 并行。面向Agent应用爆发,其超节点集群设计特别强化了热温冷KV Cache分层一跳直达能力,最大化资源利用效率。
落地建议及总结
适合立即评估的用户:计划部署万卡级AI训练集群的云服务商与大模型企业,灵衢架构的35% MFU可显著降低单位算力成本;Agent开发团队可关注鲲鹏超节点的沙箱启动与内存池优势。
建议等待观望的场景:求稳产线可考虑2027年Q2后风冷上线的昇腾960超节点,液冷方案需等到Q3;对FP16/BF16精度有强依赖的模型开发者,此次发布暂未披露对应精度算力规格。
写在最后:当算力从"卖卡"转向"卖集群”,通信能力与计算架构的深度耦合正成为新竞争维度。华为以"硅基黑土地"为愿景,将传统硬件厂商的单一优势转化为体系化系统工程能力。