凌序之心Lynx|GitHub深读:colibri|用普通电脑跑千亿参数大模型
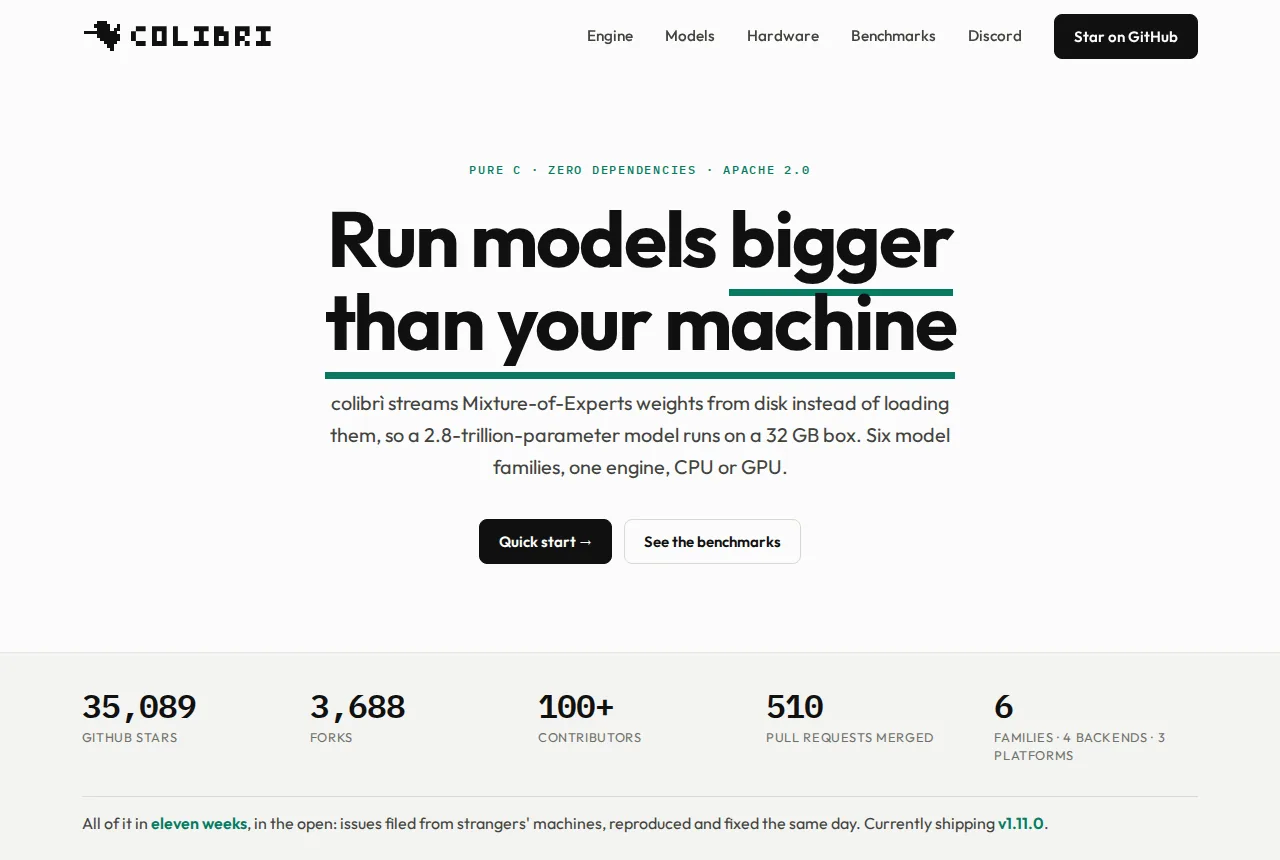
今天 GitHub Trending 冠军来了一件小事:你家里的笔记本或老工作站,理论上已经能运行一个拥有 7440 亿参数的前沿大模型。
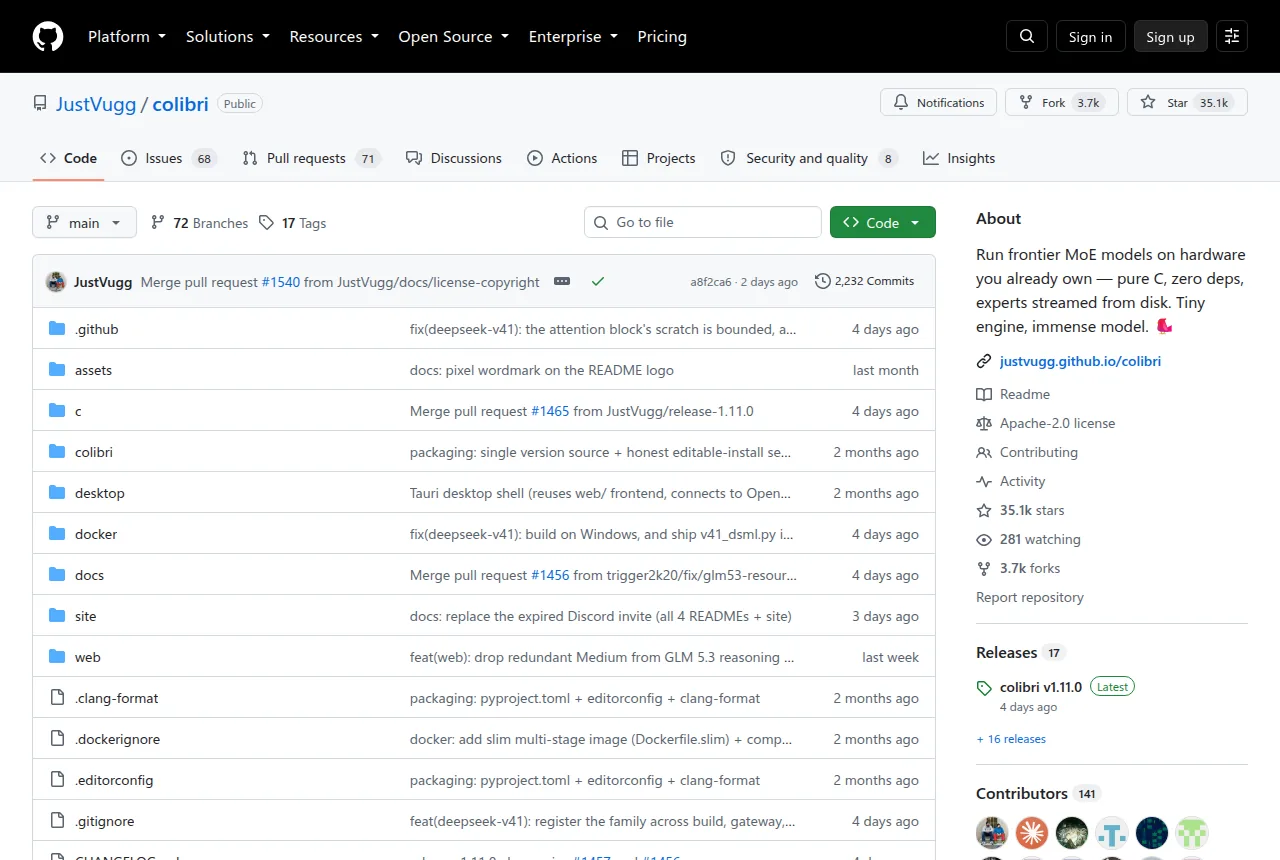
这个项目叫 colibrì(发音近似“可立比”),一个仅用 C 语言写成、零外部依赖的推理引擎,今天在 GitHub 收获了 1546 颗新星星——它让所谓“前沿模型”不再只属于云厂商的 GPU 集群。
核心功能:把满满内存、硬盘和显存当成同一张“纸”
Colibrì 的核心思想是把 VRAM(显存)、RAM(内存)和 NVMe(固态硬盘)看作统一的存储分层,而不是被硬件割裂的孤岛。当显存不够时,它不再报错退出,而是把一部分计算任务“挪”到内存甚至硬盘上继续运行,只是速度稍慢——但模型行为本身不会改变。
这意味着:
- 一个 7440 亿参数的 GLM-5.2 模型,实际运行时只激活约 400 亿参数
- 只需 9.9GB 物理内存即可启动,
- 支持九种模型家族:GLM-5.2/5.3、Inkling、Kimi K3、DeepSeek V4系列、Qwen3、OLMoE 等
网页控制台(执行 ./coli web 即可打开)提供了直观的模型运行视图:每一层的路由热力、显存与内存的占用比例、专家激活分布,乃至一个真实大脑般的专家网络流动图——19456 个专家全部可视化展示,
上手实测:五步启动千亿元素
项目提供了极其简洁的命令行界面,整个使用流程控制在十行以内:
| |
全部交互通过 coli 这一个命令完成:chat 对话、serve 开 API 服务、web 打开可视化监控页——没有额外二进制、没有 Python 运行时、没有 pip install 的依赖地狱。
技术亮点与设计哲学
Colibrì 的设计取舍非常鲜明,它更像一个推理实验室,而非成熟产品:
专家流式调度:模型中的“专家”(即多个子网络)不会一次性加载到内存,而是按需从硬盘读取,类似 JIT 编译器按需加载代码;
- 它内置 LRU 热点缓存策略,重复使用的专家会被优先保留在高速内存中
- 支持单层“ ahead”预读,但开发团队承认这在某些机器上反而变慢——因此可按需开关
I/O 与计算重叠:显存拷贝与模型推理可以并行进行,CPU/GPU/Metal 设备可混合调度
- 支持 O_DIRECT 直接 I/O 减少内核缓冲开销
- 双 SSD 条带化读取已实现,但团队明确表示仍需社区共同验证环境差异
无损语义保证:这是 Colibrì 的红线——当显存不足,它不会悄悄降低精度(比如 int8 全部换成 int4),也不会更换路由器来“凑合”.速度可能下降,但回答的正确性不会被牺牲
专注端到端优化:作者坚持一个实验必须“从.prompt 到输出”全过程可测量,而非只看单算子微基准;因此项目内多数特性都有实测数据支撑,但未承诺 SLA(服务等级协议)
适合谁用?与同类项目的差异
- AI 教学与研究者:可低成本验证MoE架构的各类策略,无需租用昂贵 GPU 节点
- 本地部署实践者:希望在自有机房或笔记本跑大模型者,它提供了比 llama.cpp 更激进的内存分层方案
- 系统工程师:对存储 I/O、异构调度、专家放置算法有兴趣者,它的代码结构精简到仅一个 C 文件 × 模型数
相比主流方案:
llama.cpp 等项目更成熟但更“保守”:一旦超内存上限就拒绝运行
vLLM 等云方案偏重吞吐与并发,面向多用户服务场景
Colibrì 则选择牺牲部分稳定性与易用性,换取对推理侧性能的极致实验自由度
硬件门槛低:普通消费级笔记本即可启动千亿元素模型
实验成本低:一次 A/B 测试只需重跑一次命令行
透明度高:所有优化必须用端到端结果说话,无黑盒承诺
写在最后
colibrì 的意义不在于当下它的推理速度是否最快,而在于它重新定义了“前沿大模型”的可及性——当一个 7440 亿参数模型可以安装在任何一台你的旧电脑上,我们可以真正把它当作实验对象来观察、测量、改进,而不是隔着 API 屏幕猜测。
它更像一份开源邀请函:一个模型好不好,不应只取决于厂商的算力预算,更该取决于我们是否愿意动手拆解它、理解它、最终改进它。
项目主页:https://justvugg.github.io/colibri