混合注意力架构成为新主流:GLM-5.3-Flash配置公开
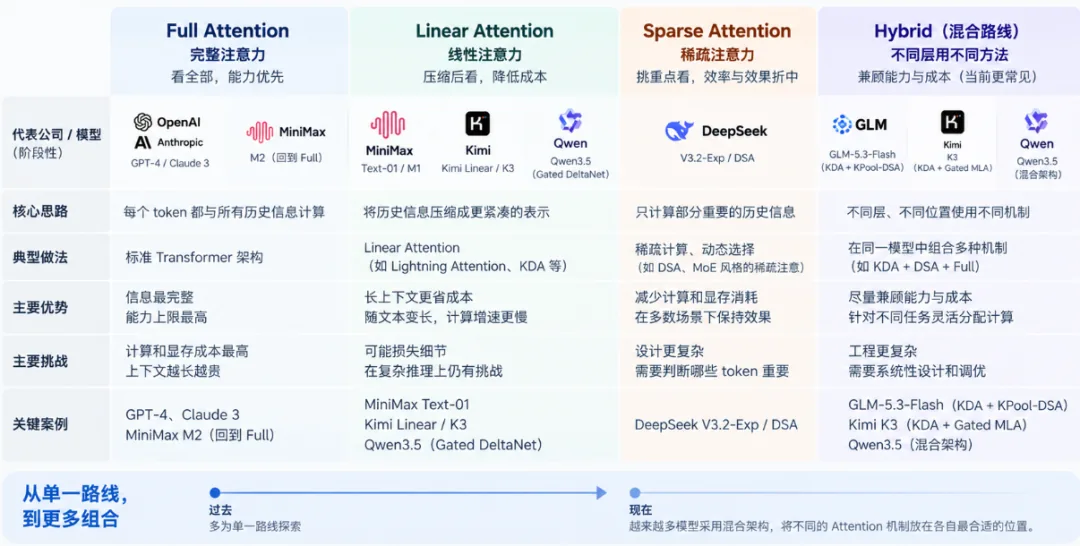
智谱AI于近期公开GLM-5.3-Flash项目配置文件,揭示其45层模型架构采用混合注意力设计:34层采用Kimi路线的KDA线性注意力,11层采用DeepSeek路线的KPool-DSA稀疏注意力。这一配置标志着大模型架构正从早期追求单一高效注意力机制,转向多机制协同分工的组合路线。
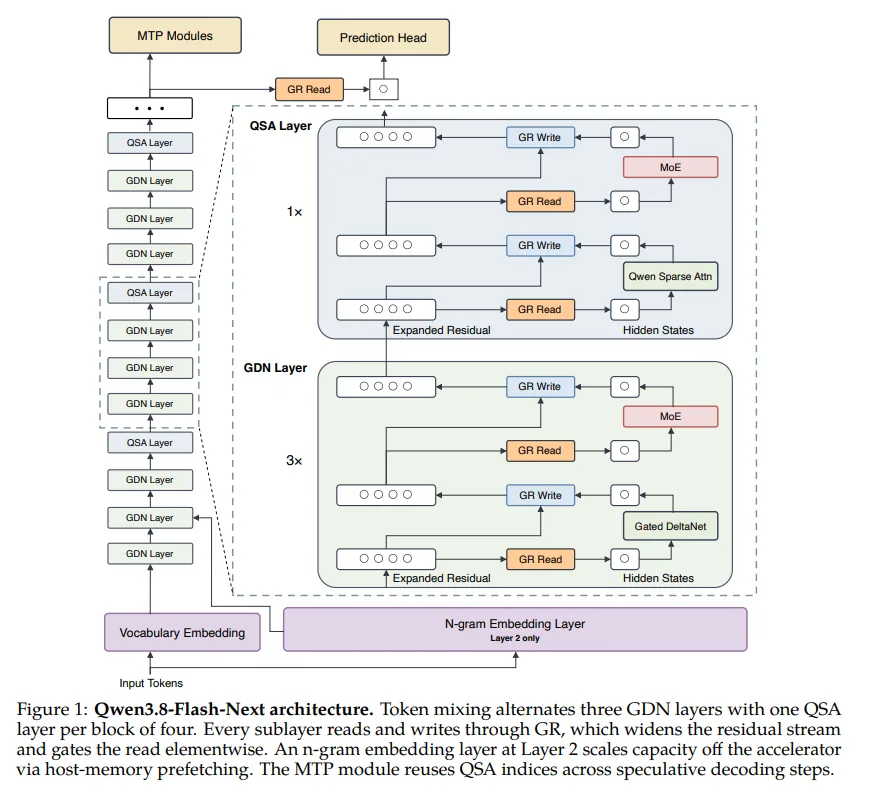
与GLM-5.3-Flash同期,Qwen3.8-Flash-Next同样延续类似思路——四层结构中三层为Gated DeltaNet,一层采用Qwen Sparse Attention。MiniMax则在M3版本中转向自研的MiniMax Sparse Attention(MSA),将上下文处理计算量压缩至前代的1/20(100万token场景下)。这些更新共同指向一个趋势:过去被视为兜底方案的全局注意力,正逐渐被更精细分工的混合机制替代。
技术路线从竞争走向协同
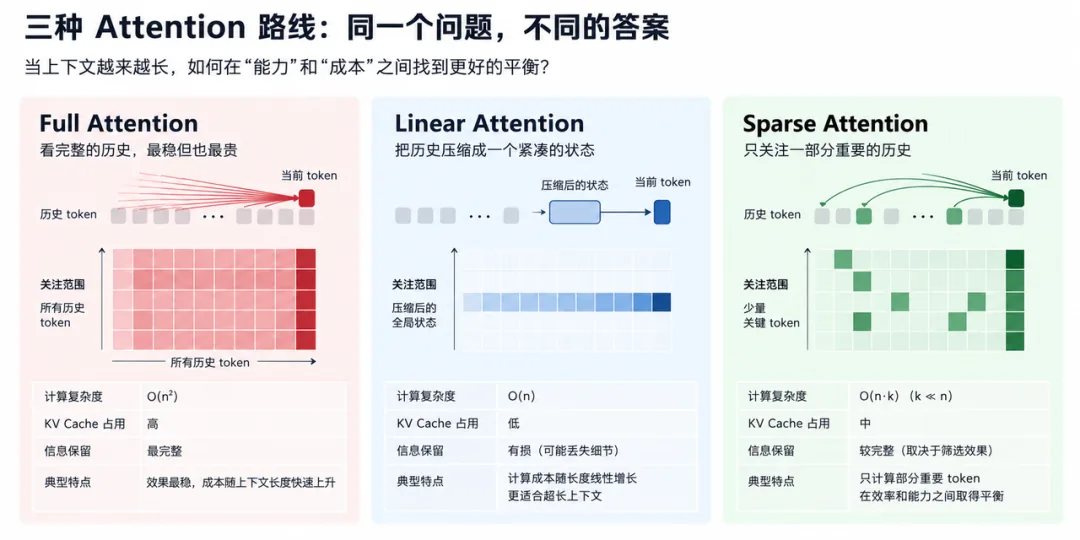
注意力机制主要分三类:全局注意力(Full/Global Attention)保留完整token历史但成本高;线性注意力(Linear Attention)通过压缩历史降低计算成本;稀疏注意力(Sparse Attention)保留token级历史但仅选择性参与计算。过去几年,三者常被理解为竞争关系:MiniMax曾全面押注Linear Attention(M1),后因多跳推理能力损失风险,在M2重新切换回Full Attention;M3则因Agent任务导致长上下文成本飙升,转向MSA稀疏方案。
关键反差点在于:Kimi与DeepSeek的技术原本分属不同技术阵营,如今却被同一系列模型采用。开源社区FLA maintainer杨松琳2024年维护FLA时,已提出Linear与Sparse结合的构想;KDA与DSA的共存正是这一判断的实践印证——前者负责维持长历史整体状态,后者负责精确检索具体内容,二者在职能上形成互补而非替代。
技术扩散加速推动架构重组
开源社区、代码共享与研究人员流动正在缩短技术迭代周期。FLA开源社区不仅开放算法,还统一接口、kernel与实现,为Kimi推进KDA提供了基础设施支持。当技术不再仅依附于论文传播,而可通过可复用代码跨越公司边界时,所谓"技术路线"的定义随之改变:
- MiniMax曾代表Linear路线,现转向Sparse
- DeepSeek以稀疏注意力著称
- Kimi主导KDA线性方案
但真正拉开差距的,已非"是否拥有某项技术",而是何时采用、如何组合,以及在能力、成本与工程风险间的权衡能力。M2时期MiniMax曾为能力确定性接受Full Attention的高成本;M3时Agent场景让该"保险"价格过高,促使团队再次转向稀疏方案。技术无优劣,约束条件变化才驱动架构更迭。
| 模型 | 注意力架构特征 | 核心参数/能力表现 | 核心变更动因 |
|---|---|---|---|
| GLM-5.3-Flash | 34层KDA + 11层KPool-DSA | 45层混合架构 | 职能分工:整体记忆 vs 精确检索 |
| Qwen3.8-Flash-Next | 3层GDN + 1层QSA | 继承前三层结构,替换Attention为稀疏方案 | 全局注意力功能迁移至高效机制 |
| MiniMax M3 | MiniMax Sparse Attention | 上下文处理计算量约为上一代的1/20 | Agent长工作历史导致成本不可持续 |
读者落地建议
适合采用混合注意力架构的新模型开发者:若需在长上下文处理与计算成本间平衡,且任务包含多跳推理或精确检索混合需求,可参考KDA+DSA组合范式,将流程拆分为"状态维持-热点检索"两阶段。建议再观望的技术团队:若当前应用限于中短上下文(<10万token),全局注意力或轻量级线性注意力仍具成本优势;混合设计的复杂性可能抵消其理论收益。
写在最后
注意力机制正从"寻找最优解"转向"定义最优组合",技术扩散与组合创新已成为大模型演进的核心引擎。真正难以复刻的,是团队对下一阶段约束条件的前瞻性判断能力。