结论先讲:抖音「花花有话说」那支 17 分钟的《蟒蛇行动:塔库尔加尔山上的最后坚守》下集,不是从零制作的——逐帧对比显示它高度疑似搬运自 YouTube 频道 The Operations Room 的同题材视频(综合置信度约 0.86);而「神秘园SMY」的洞穴探险解说,是原创的三维地图可视化 + 公开资料整合。两者同属一个内容类型——「旁白驱动的地图叙事」(map-driven narrative),但一条走搬运流水线,一条走自制流水线。想复刻,复刻的是后者。
起点:一条分享链接
朋友扔来一条抖音分享口令,视频是「花花有话说」的《蟒蛇行动:塔库尔加尔山上的最后坚守 下集》,配了 #军事 #阿富汗 #海豹突击队 的标签。他问了两件事:这视频的原始出处是哪个 YouTube 视频?它和「神秘园」那种洞穴探险解说,属于什么类型、能不能复刻?
蟒蛇行动(Operation Anaconda)是 2002 年 3 月美军在阿富汗沙希科特山谷发起的攻势,塔库尔加尔山(Takur Ghar)上那场后来被称为 Roberts Ridge 的战斗是其中最惨烈的一段:一架直升机被 RPG 击中坠落在山脊,机组和救援的特战队员被围困,空军战斗控制员 John Chapman 战死在这座山顶,后来被追授荣誉勋章。
这段历史在英文互联网上资料极多,做它的中文解说视频,素材从哪来,是判断「原创还是搬运」的关键。
方法:下载 → 切帧 → 对比
我的验证流程和跑数据工程没区别,三步:
第一步,把视频拿下来。 抖音的 CDN 有 Argus 风控,普通 curl 和 yt-dlp 都会被拦在「Fresh cookies needed」。我复用了 OpenClaw 工具箱里的 Playwright 登录态(douyin-state.json),在浏览器上下文里调 /aweme/v1/web/aweme/detail/ 接口拿到 play_addr 直链,再带 Referer 下载——168MB,1080p,30fps,时长 1019 秒,一次成功。
第二步,逐帧切片。 ffmpeg 按 1fps 抽帧,得到 1020 帧;每 5 秒取一帧拼成 6 张 contact sheet(每格标注秒数),再交给视觉模型逐张分析素材构成。这正好是 video2script 项目「三通道抽取」思路的轻量版:视频是临时加工对象,抽出来的结构化信息才是资产。
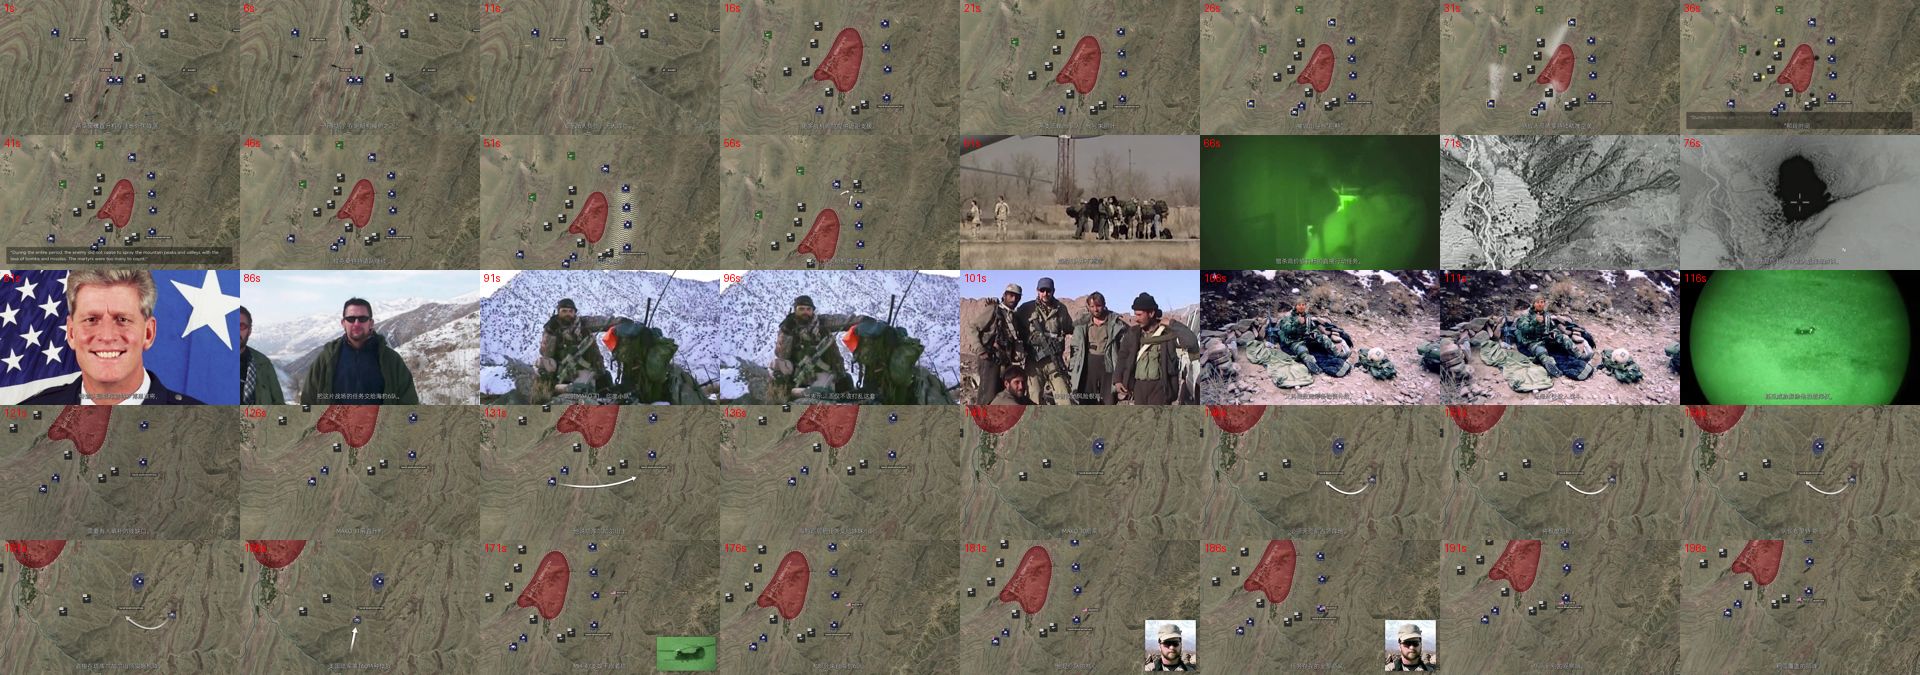
上面这张 contact sheet 就是分析的原材料——202 格画面压缩成一张图,素材类型的分布一眼可见:大片重复出现的灰褐色地形图是主轴,中间几排穿插人物照片和夜视画面。后面所有关于「地图占 70–80%」的数字,都是从这类拼图里数出来的。
第三步,找原片做对照。 英文侧做动画战史解说的频道里,The Operations Room 有一支 51 分钟的《Medal of Honor - The Heroic Last Stand of John Chapman - Operation Anaconda》——同一座山,同一场战斗。我下载了它的前 10 分钟,同样切帧拼图,然后让模型做双图对比。
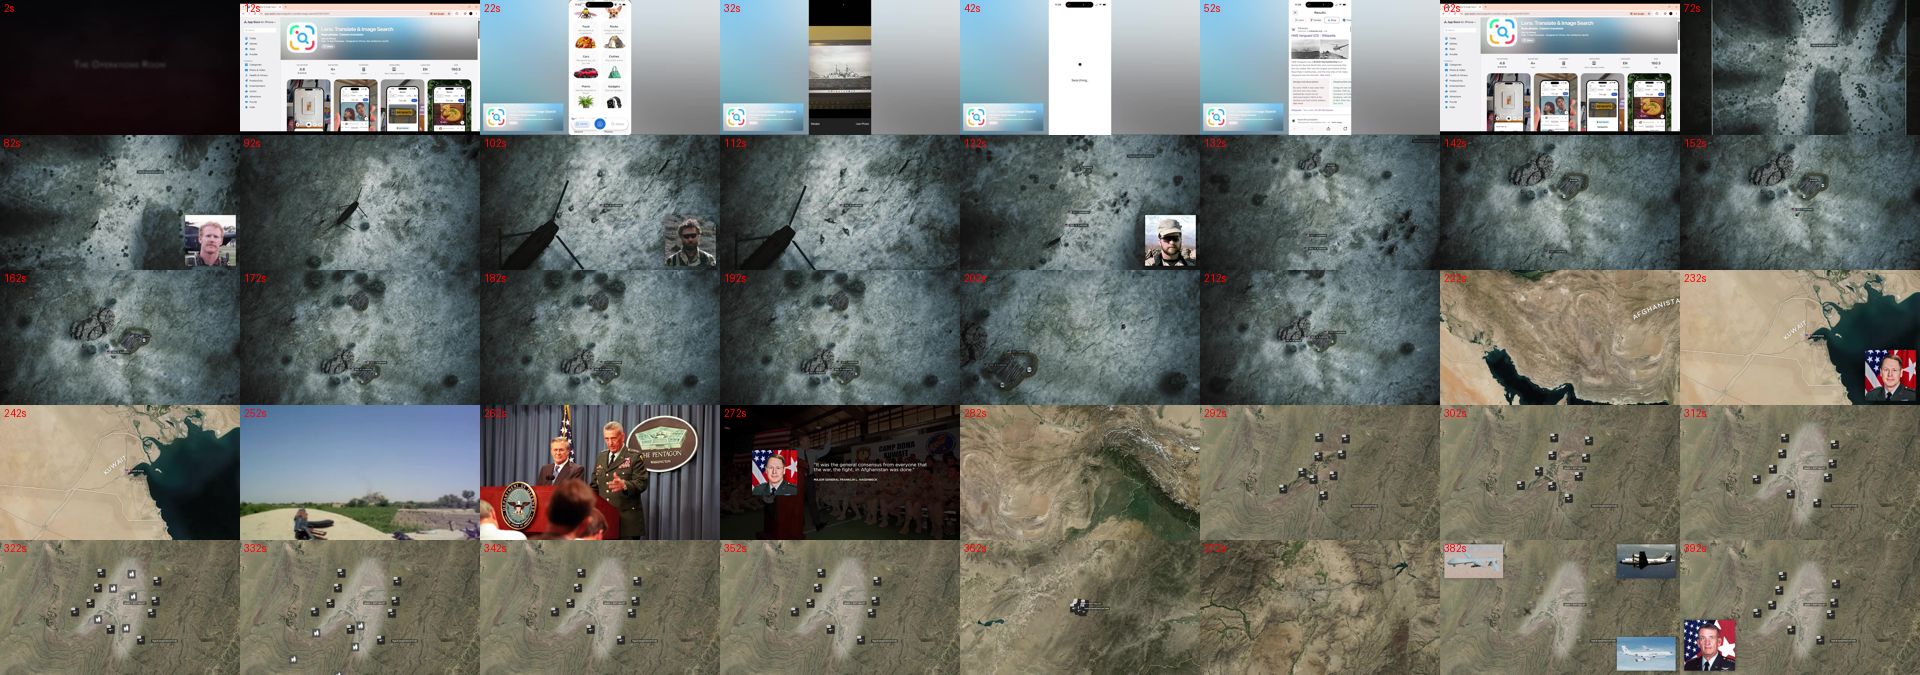
两张拼图摆在一起,同源性不用逐帧对齐也能看出个大概:相同的卫星纹理、相同的图标密度、相同的红蓝标注逻辑。
军事解说:拆出来的三个数字
对抖音那支视频的逐帧统计(前 200 秒采样,视觉模型判定):
- 动画战场地图占 70–80%:卫星地形底图 + 半透明红色敌区 + 蓝白单位图标 + 弯曲箭头,图标和箭头随旁白逐步出现
- 真实档案照片占 10–15%:Chapman 肖像(背景带美国国旗)、部队合影、阵亡者照片
- 档案影像占 5–10%:绿色夜视、灰度航拍/热成像
- AI 生成图 0%,游戏画面 0%:没有枪械结构错乱、手指畸变这类 AI 军事图的高频错误,也没有任何 HUD 准星
抽一张完整单帧看细节更直观。150 秒处这张是全片的典型画面:
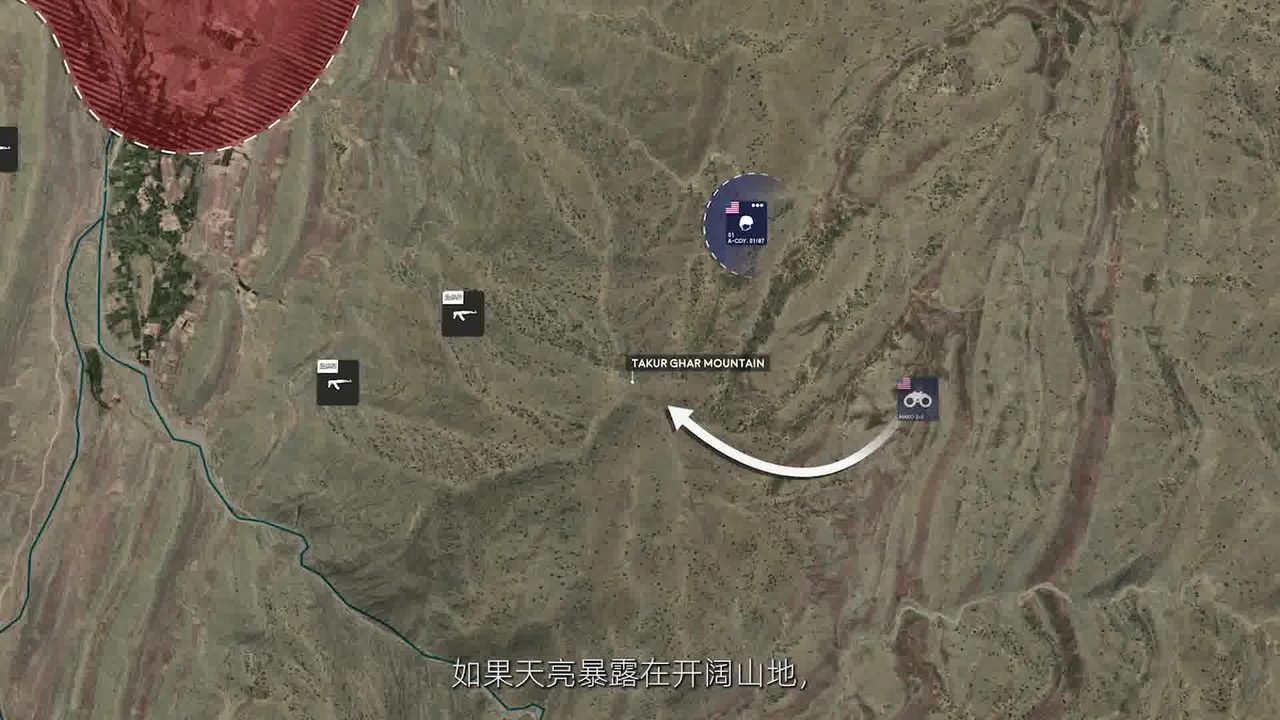
注意三个元素:地形图上标注的英文地名 TAKUR GHAR MOUNTAIN(原封不动的英文标签,搬运的典型指纹——如果是自制动画,中文频道通常会把地名翻译或双语标注);左上角半透明红色区域标示敌方控制区;画面底部是后期加的中文解说字幕。英文原始图层 + 中文字幕覆盖,这个叠加结构本身就是翻译搬运视频的标准形态。
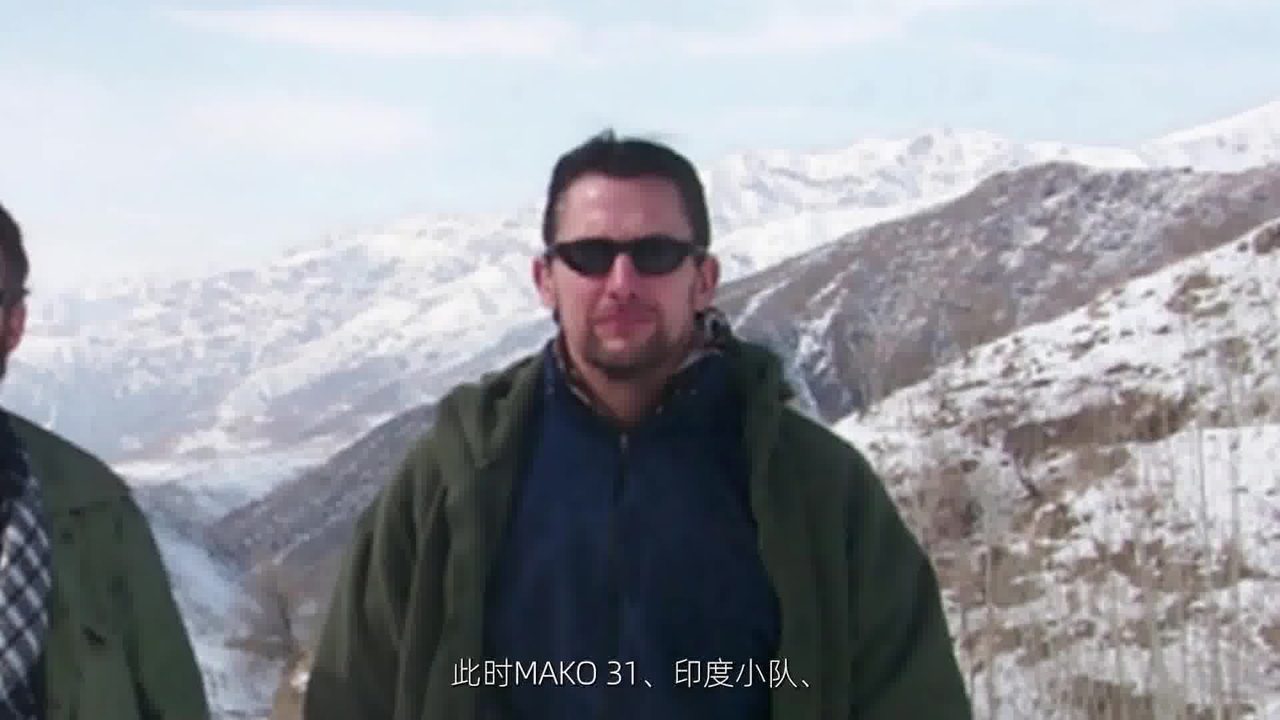
人物介绍段的处理方式也一样:原始画面(这帧是戴墨镜的队员站在雪山峡谷前,讲的是 MAKO 31 侦察小队的部署)直接沿用,下方叠中文字幕。旁白念到哪个小队,字幕就打到哪个小队。
单看这些,只能说明它是标准的「动画地图战史解说」。真正定性的证据来自双图对比——抖音视频与 The Operations Room 那支的相同题材视频:
| 对比项 | 判定 | 置信度 |
|---|---|---|
| 地图底图同一区域、同风格 | 是 | 0.85 |
| 图标/箭头/配色体系 | 高度一致或仿制 | 0.88 |
| 人物照片同批(含 Chapman 肖像) | 很可能重合 | 0.75 |
| 疑似同源翻译搬运 | 成立 | 0.86 |
决定性的细节是:两支视频的地图都用同一套「灰褐色卫星纹理 + 蓝白友军图标 + 半透明红色敌区 + 简洁曲线箭头」的语言,抖音版的红色态势区与 The Operations Room 后半段的战术图在形状和位置上高度接近——这不是「同一事件所以地图类似」能解释的,更接近同一套可视化资产被翻译、重剪、配了中文旁白。
把两边的地图帧并排看,相似度超出了「风格借鉴」的范畴:
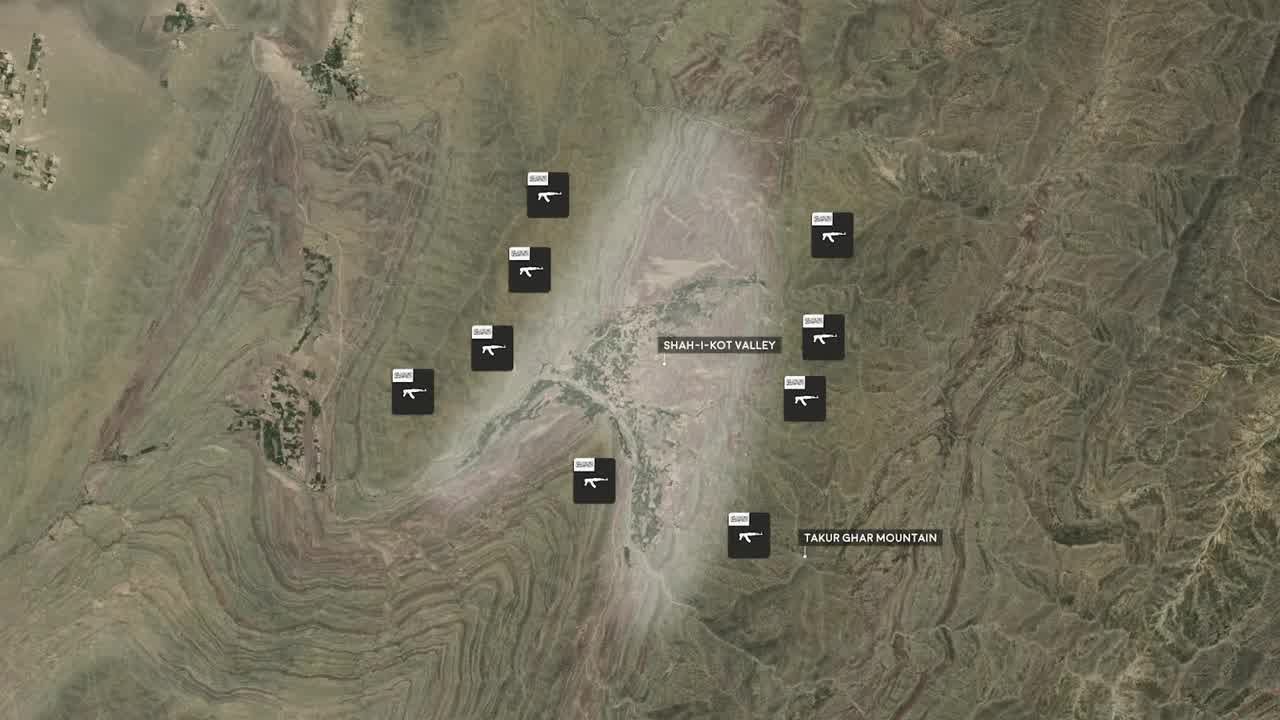
这是 The Operations Room 的地图帧:黑色方块是武器阵地图标,英文标签标出 SHAH-I-KOT VALLEY 和 TAKUR GHAR MOUNTAIN——地名拼写、标注位置、图标画法和上面抖音那张 150 秒帧完全对应。唯一的差异是抖音版多了中文解说字幕。同一战场、同一视角、同一套军标词汇,两条独立的制作线撞车撞不出这种精度。
另一个佐证藏在账号简介里:「花花有话说」的签名写着**「素材不是我做的,来自各方大佬」**。作者自己说了素材不是自制的。
所以第一个问题的答案:这类型的英文源头是 The Operations Room(以及 Kings and Generals、Armchair Historian、Battle Order 这一批做动画战史推演的频道),中文短视频军事解说的主流生产方式,就是把这批频道的成品做翻译搬运——重配音、重剪节奏、拆上下集。原文当然是英文的。
神秘园:同一种类型,另一种做法
「神秘园SMY」(B 站空间、抖音主页)是这两年探险事故解说赛道的头部,全网涨粉过百万,抖音单月涨粉四百多万的成绩也被行业媒体专门分析过。它的选题集中在洞潜、洞穴探险、徒步事故、极限户外——腾讯新闻的评价是「每天都在传来噩耗的洞穴探险视频,成了互联网顶流下饭菜」。
我下载了它一支近期视频(《10 人新疆夏塔古道徒步,1 人遇难 1 人失踪》,11 分钟,B 站油管抖音三平台分发),同样逐帧拆:
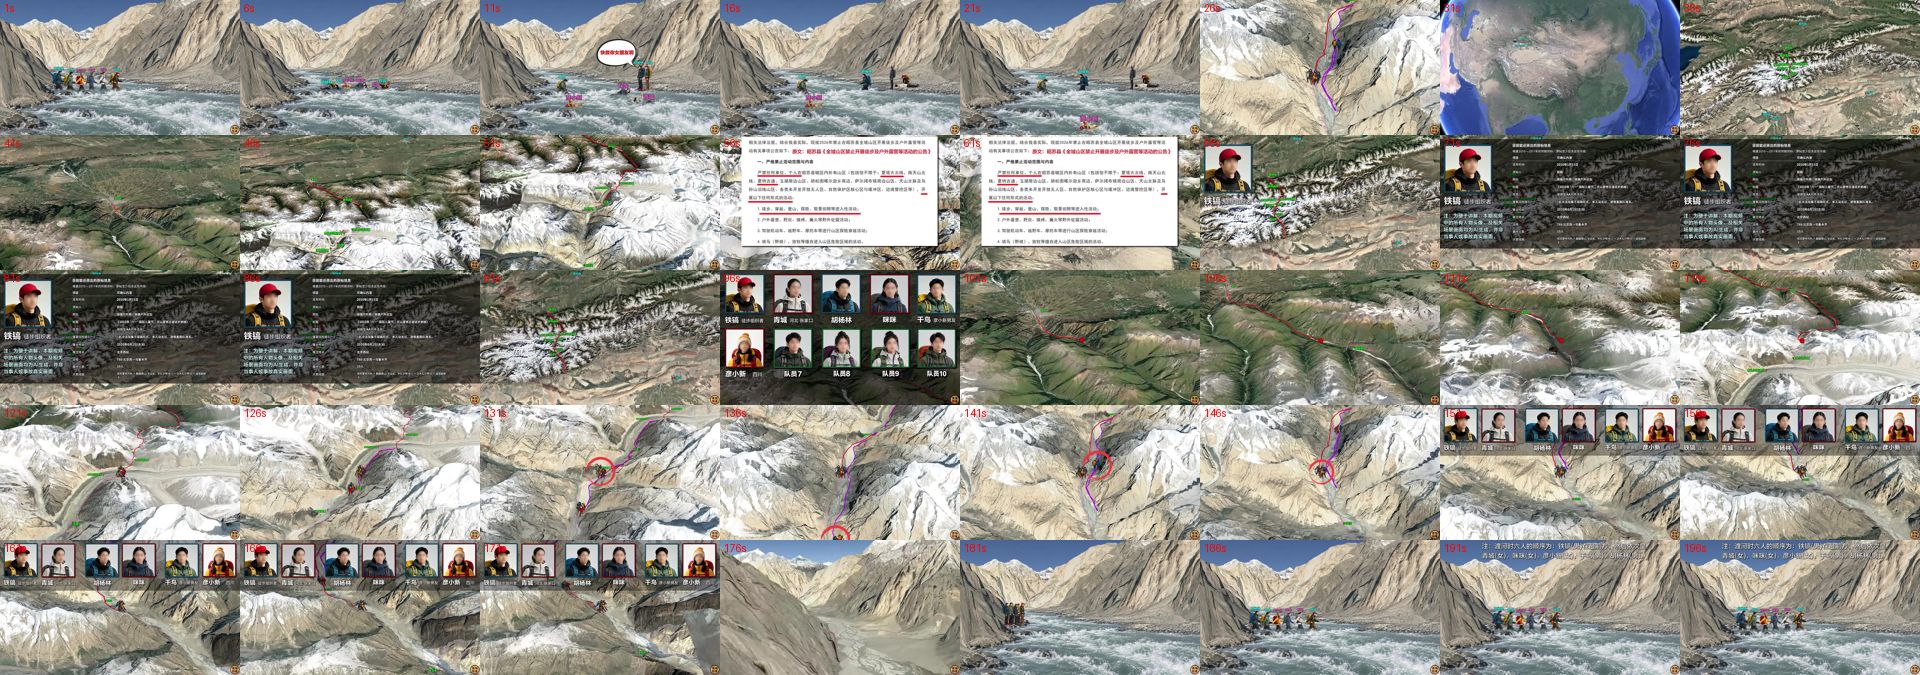
- 三维地形地图动画占 55–65%:Google Earth 式卫星地形,镜头从宏观区域飞行推进到具体山谷,路线逐段点亮,红圈定位
- 示意动画/信息图占 15–20%:队员头像阵列、人物资料卡、黑色半透明信息框、红圈标注
- 新闻/通报截图占 8–12%:白底公告加红色高亮,制造「事实来源感」
- 真实影像/场景素材占 10–15%:雪山、河谷氛围画面
单帧看它的自制痕迹。100 秒处是全片的「人物阵容」卡:
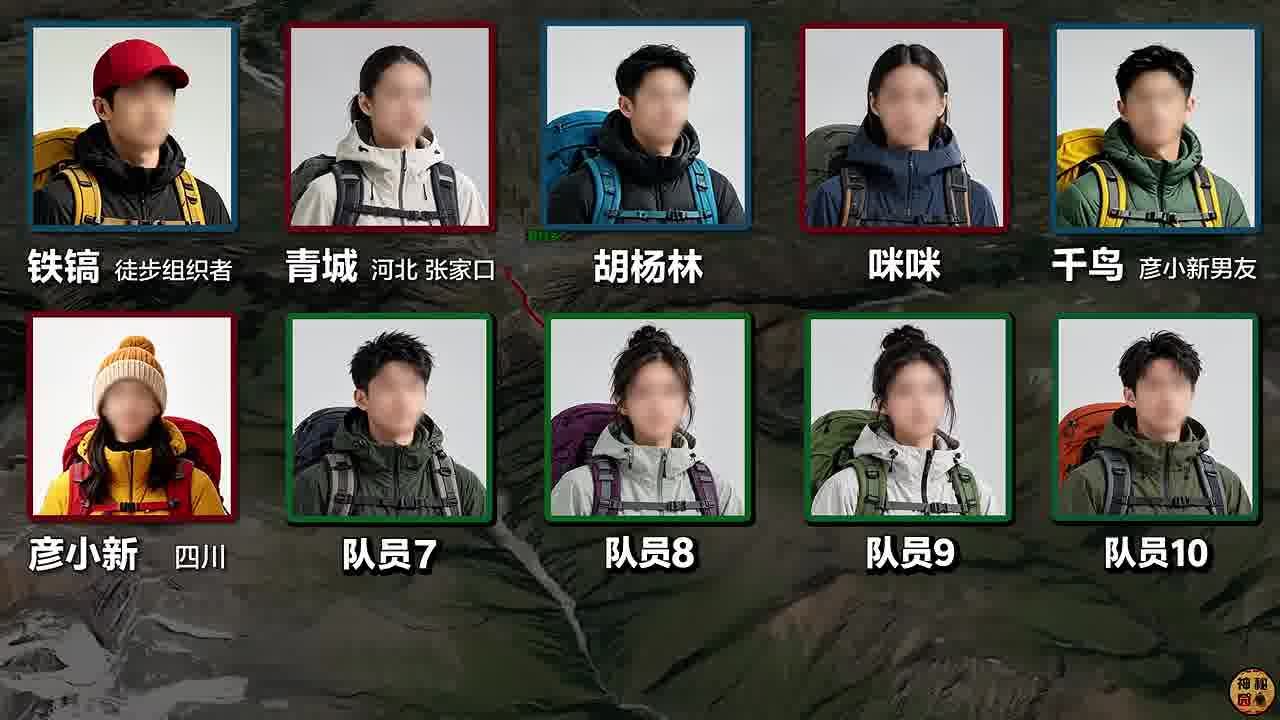
十名队员的头像两行排列,头像边框用红/蓝/绿三色区分队伍分组,每人下方标注姓名和身份,背景压暗色地形图。这是典型的自制信息图——素材照片可能来自公开来源,但头像阵列的排版、分组配色、标注体系是频道自己的设计语言,在军事那支视频里找不到对应物。
200 秒处进入纯地图叙事段:
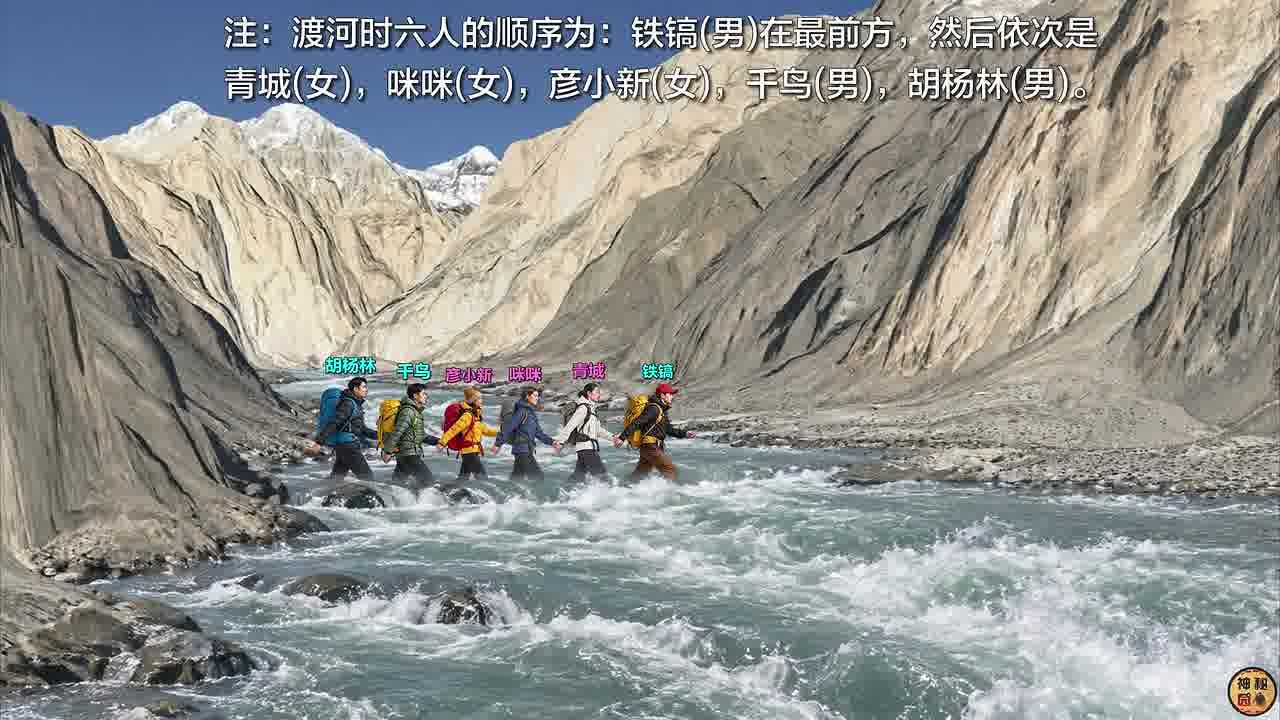
和军事那支的关键差异在这张图上:地图标注全是中文,路线点亮节奏跟着中文旁白走,地名、单位、图例都为中文观众重新做过——而不是英文标签留着、字幕翻译盖上去。这就是「自制」和「搬运」在帧层面的分界线。
判定与军事那支截然不同:原创。地图动画的镜头路径、路线设计、人物标注体系是频道自制的(底图来自地图平台,属于正常的素材使用),叙事结构是标准的「事故复盘」:开场悬念 → 人物阵容 → 时间线推进 → 关键节点放大 → 结果与反思。旁白驱动,画面跟着旁白走。
同一个类型,两种生产线的分界线就在这里:素材是自制的可视化动画,还是别人的成品画面。
它们属于什么类型
这两类视频在内容工业里其实是同一个物种,我称之为「旁白驱动的地图叙事」(narrative map-driven video)。特征清单:
- 画面不承担叙事,旁白承担。所有镜头都是旁白的可视化辅助——旁白说到哪里,地图就推进到哪里
- 地图是主叙事载体,占 50% 以上画面,用空间关系(谁在哪、往哪走、被什么包围)制造张力
- 真实素材做证据层:档案照片、新闻截图、夜视影像穿插,制造可信度
- Ken Burns 运镜:静态图缓慢推拉平移,掩盖「其实没有实拍素材」的事实
- 题材天然带死亡与悬念:战斗、事故、救援,全是绝境叙事
英文世界的成熟谱系:战史侧是 The Operations Room、Kings and Generals;事故侧是探洞圈的匿名解说频道(BB姬那篇文章描述的「坚果油灰洞事件」整个解说生态)。中文侧基本是镜像:军事区大量搬运翻译,探险区出现了神秘园、三更研究所这类做原创地图可视化的频道。
为什么这个类型能爆?因为它的生产成本结构极其友好:不需要实拍、不需要出镜、不需要演员,一台电脑 + 地图软件 + 剪辑软件 + 一个会写文案的脑子就能开工,而题材(绝境、死亡、救援)自带完播率。
想复刻:走神秘园的路线,别走搬运的路线
如果目标是复刻这类视频,可行路径是神秘园模式,流水线拆开是五段:
- 选题:找「有完整时间线 + 有地理空间 + 有生死悬念」的真实事件。事故复盘、山难、洞穴救援、历史上的绝境战斗都是矿
- 资料:官方通报、新闻报道、当事人访谈、论坛考据,把时间线精确到分钟——这是内容的骨架,也是和纯搬运的差异化所在
- 可视化:地图平台(Google Earth / 奥维 / Mapbox)做地形底图,AE 或剪映做路线动画、头像卡、信息框。神秘园的标注体系(红圈/箭头/头像阵列/黑底信息框)是值得抄的「词汇表」
- 文案:旁白按「悬念开场 → 人物 → 时间线推进 → 高潮节点 → 结果」结构写,每 300–500 字留一个视觉锚点
- 配音剪辑:AI 配音已经完全够用,Ken Burns 运镜 + 硬切/推拉转场,节奏跟着旁白走
至于军事那条搬运线——它确实跑得通(花花有话说那支 17 万赞),但版权状态是灰色的,The Operations Room 的素材带水印可溯源,平台对搬运号的打压周期性收紧。做长期资产,不值得把地基打在别人的素材上。
最后一个具体事实收尾:John Chapman 的那场战斗发生在 2002 年 3 月 4 日凌晨,他孤身在山顶掩体里与敌近距离交火,阵亡时 36 岁;2022 年,他成为空军第一位追授荣誉勋章的战斗控制员。这段历史在英文维基、空军官方战史和 The Operations Room 的 51 分钟视频里都在——中文观众看到它的那条 17 分钟的抖音视频,是这条传播链的最后一环。