
核心事件
纽约舆论与法律界近日聚焦一起重大司法案件:《纽约时报》诉 OpenAI 与微软案中,一批新解封的法庭文件引发广泛关注。文件显示,两家公司高管在项目早期即已意识到其AI训练模式将对网络生态造成系统性破坏,却仍选择继续推进。
关键事实如下:
- 文件源于《纽约时报》提起的版权诉讼,最近由法院解封
- 揭露时间未公开披露,但内容涉及2022—2023年项目内部讨论
- 当事人包括OpenAI联合创始人Greg Brockman、首席执行官Sam Altman、微软CMO Satya Nadella等人
- 据文件所载,相关高管对训练数据采集行为合法性提出内部质疑
- 案件尚未进入最终判决阶段
内部警告:末日循环与“劳动力盗取”
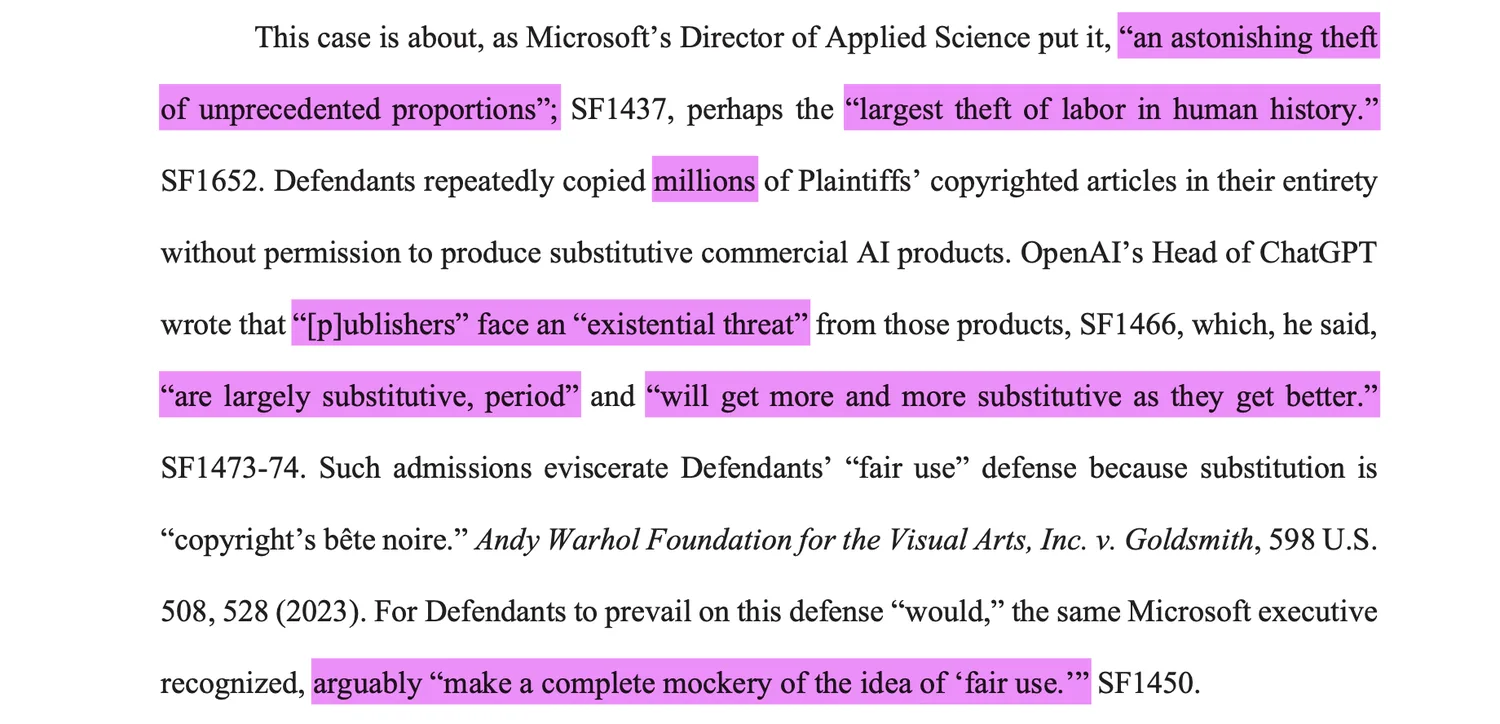
文件中最引人注目的莫过于微软应用科学总监Brent Hecht的内部表述。他称ChatGPT与Copilot的数据抓取行为是“人类历史上最大规模的劳动力盗取”,并指出微软的法律辩护“完全嘲弄了‘合理使用’理念”。值得注意的是,微软官方随后声明,称Hecht的言论属于“个人学术观点”,不代表公司立场。
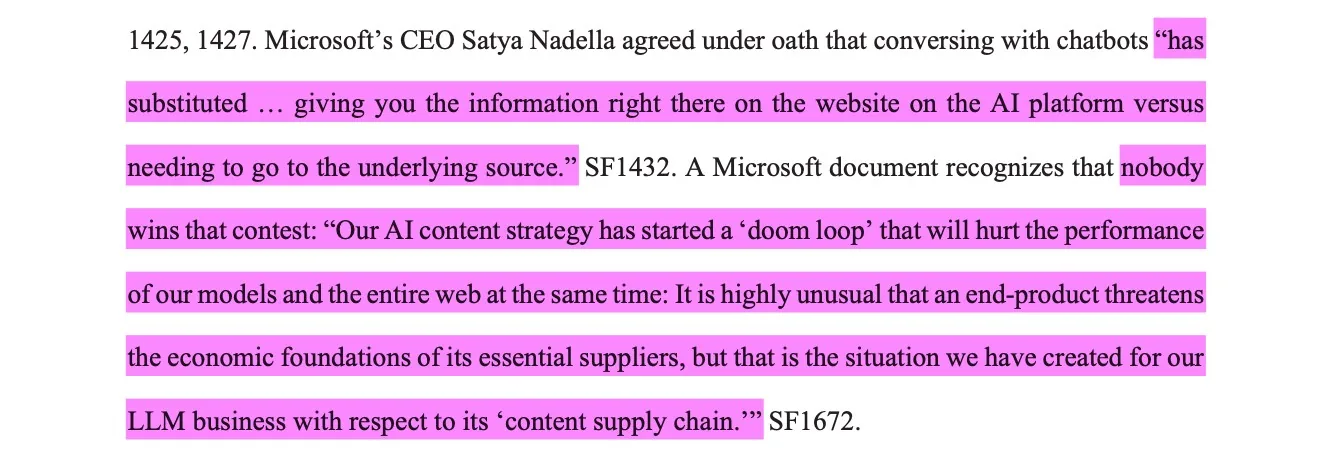
微软内部文件明确使用了“ doom loop (末日循环)”一词,指出AI内容战略“已启动一个将同时损害模型性能与整个网络生态的末日循环”,并强调:“这是一种极不寻常的情形——终端产品威胁了其关键供应商的经济基础。”
OpenAI内部文档同样存在矛盾:一方面强调“防止记忆”对“最小化版权侵权”的重要性;另一方面承认GPT-4“** memorized a ton of data and therefore will be insanely good at regurgitation **( memorized 了大量数据,因此将在复述方面‘疯狂出色’)”。文件列举的具体案例包括GPT-4逐字复述《纽约时报》《华盛顿邮报》《 LifeHacker 》《 Eurogamer 》等媒体的长篇报道。
盈利动机与追踪失控
尽管公开场合强调版权合规与授权倾向,私下文件暴露出另一副面孔。微软全球首席执行官Satya Nadella虽表态“应为付费墙内容付费”,但OpenAI代表承认**“并未采取任何措施 detection or remove paywalled content from training data **(检测或移除付费墙内容)”。这一反差凸显了公开承诺与内部实践的巨大鸿沟。
OpenAI政策总监Jack Clark曾预警,其系统正在“创造用以替代定义社会‘文化’之人劳动的系统”,并将ChatGPT内部称为“**现代新闻亭 (the modern newsstand)”。其ChatGPT产品负责人Nick Turley直言,用户获取AI摘要后“没有合理理由再点击源链接”,直接导致 publishers ** referral traffic (推荐流量)大幅下滑——OpenAI内部专家推测下降幅度可能高达60%。
微软发言人虽辩称 Nadella 的证词仅代表“宏观趋势观察”,不涉及版权问题的法律立场,但文件显示公司早已预见后果:其内部文件直指“**LLMs are a product that destroys its own supply chain **(大语言模型是一种摧毁自身供应链的产品)”,因AI生成内容本身即构成对原始训练数据的替代。
技术与法律的张力
此案凸显人工智能时代版权法的普遍性困境。大语言模型本质依赖海量文本训练,而训练数据中包含大量受版权保护内容。所谓“合理使用”,在美国法律下需考量四要素:使用目的、作品性质、使用数量与市场影响。文件显示,OpenAI与微软技术人员内心对此存疑,但因商业回报过于诱人而未行动。
Greg Brockman的表述尤其值得玩味——他关注焦点并非“fair use”是否成立,而是“**gazillions of dollars **(数以十亿计的美元)”商业潜力,暗示盈利驱动压倒合规考量。
| 人物角色 | 公司 | 关键内部陈述 | 来源可信度 |
|---|---|---|---|
| Brent Hecht | 微软 | “最大的劳动力盗取”;“嘲弄合理使用” | 内部邮件与文件 |
| Satya Nadella | 微软 | “末日循环”已启动;AI取代原生搜索 | 商务文档 |
| Jack Clark | OpenAI | “替代定义文化之人劳动”;“现代新闻亭” | 内部备忘录 |
| Nick Turley | OpenAI | “无理由点击源链接”; referral traffic 下跌60% | 内部交流与报告 |
读者建议
- **内容创作者与 publishers **:此类文件为未来版权诉讼提供有力证据链,建议系统性保存原始内容的时间戳与访问记录,以备潜在维权需求
- AI产品使用企业:内部文件揭示Current LLM存在“verbatim reproduction”高风险,涉及法律、医疗、金融等专业领域时仍需人工审核
- 观望者与个人用户:即便主流模型声明已改进抗抄袭机制,当前技术仍难以根除数据记忆与复现,对关键信息源需保持批判性验证习惯
写在最后
当一家公司内部文件将自身产品称为“摧毁供应链者”,技术狂飙的代价已清晰浮现——效率跃迁与系统性风险本就是硬币的两面。此案判决或将重新定义数字时代“合理使用”的边界,其影响远超两家当事企业本身。