
核心事件:英伟达开源IMO金牌推理系统
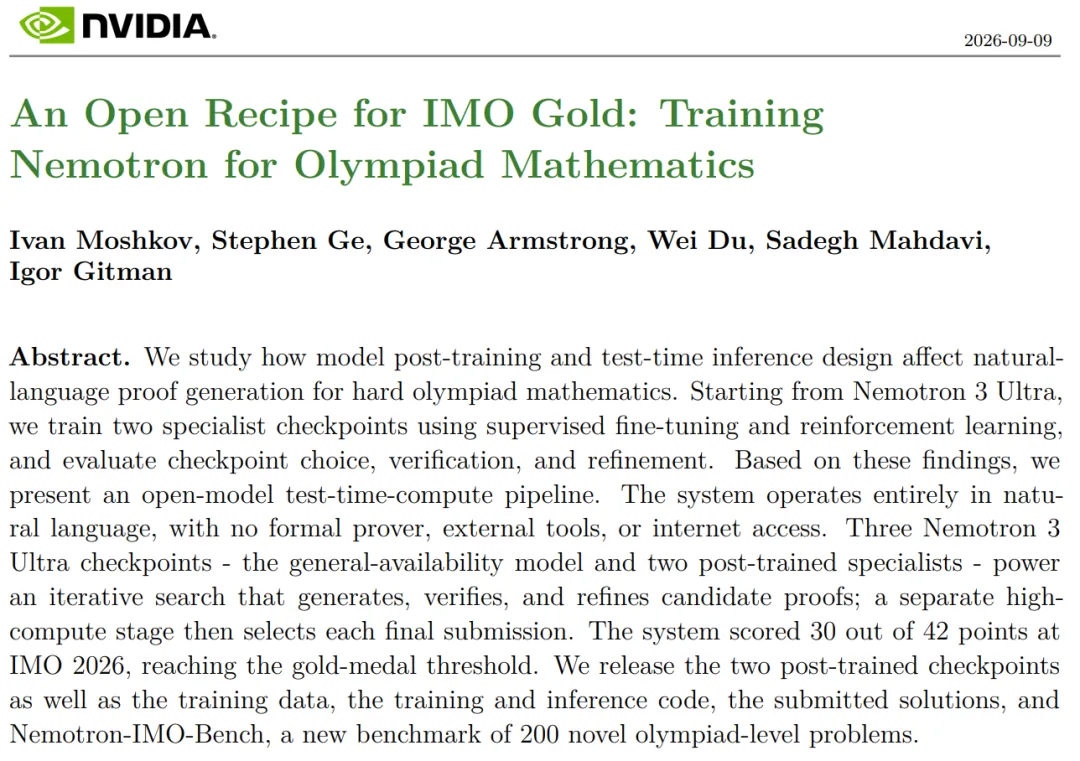
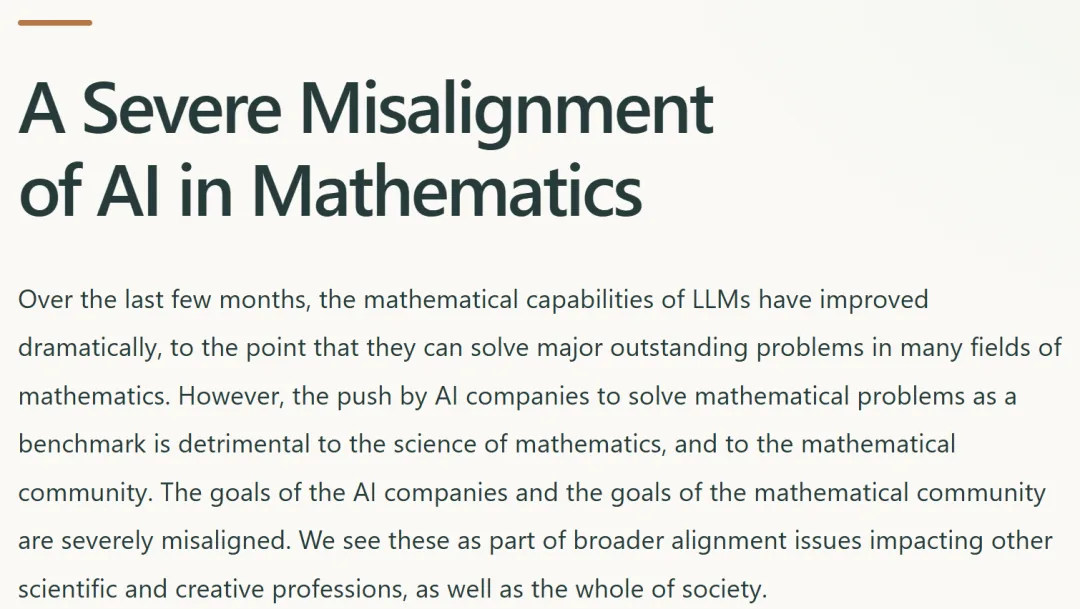
2026年9月9日,英伟达正式公布Nemotron 3 Ultra在IMO竞赛中使用的整套数学推理系统。该系统最终获得30/42分,超过当届29分的金牌线。两天后(9月11日),包括陶哲轩、Peter Scholze、Maryna Viazovska在内的25位菲尔兹奖得主联合发声,质疑AI数学成果发布的快速节奏与验证滞后问题。
本次开源传递了关键信息:
- 发布时间:2026年9月9日
- 新版本:Nemotron 3 Ultra(通用底座) + 两个数学专家checkpoint(SFT版与RL版)
- 是否开放权重:是,SFT/RL训练数据、推理代码、训练配方、验证器与200道新测试题Nemotron-IMO-Bench全部开源
- 未完全开放项:部分中间teacher和MOPD checkpoint未公开;完整后训练链未逐阶段复现
- 硬件门槛:550B参数模型运行需1.5TB显存,相当于384次初始生成+多轮refinement的长考成本
技术路径:三链协同解题,证明池机制是关键
Nemotron系统并非依赖单一模型反复采样,而是构建了三重协同机制:
- 通用底座 checkpoint:Nemotron 3 Ultra基础模型,提供通用数学能力
- SFT专家 checkpoint:经监督微调训练,擅长处理局部错误证明的修改与验证
- RL专家 checkpoint:经强化学习训练,学习调整高价值证明路线的抽样概率
这 triple-checkpoint 设计解决了有限算力下的有效样本覆盖问题——相同预算下,三个不同后训练路径生成的候选相关性更低,比单模型重复采样能探索更广的证明空间。
系统另一核心是proof pool(证明池)机制:
- 首轮生成384份证明候选
- 验证器批改后,存在缺陷但方向正确的证明进入refinement循环而非直接丢弃
- 修改后的结果重返证明池,与原路线共同竞争资源
这一过程使系统具备搜索深度与宽度兼顾的能力。与传统暴力采样不同,系统会动态将计算资源投向高评价路线,避免每次从零开始。
反差现实:1.5TB显存门槛 vs “代码平权"承诺
英伟达开源的"平权"姿态与真实硬件门槛存在明显反差:
- 开源包含完整训练数据与配方,理论上可复现流程
- 但550B模型运行需1.5TB显存(约数千GB200 GPU小时)
- 8张B200显卡+1464小时的长考成本,将全球99%高校实验室拒之门外
更值得警惕的是验证器的错误相关性问题:
- 尽管使用三个checkpoint交叉验证,系统仍漏过存在明确反例的错误证明
- 原因在于三者共享同一底座模型,存在共同的理解盲区
- 验证器为降低误放行率设高门槛,导致大量正确证明被拒
这揭示出该技术路线的深层矛盾:生成能力可随算力线性扩展,验证器却缺乏同样稳定的scaling路径。
验证瓶颈与未来挑战
NVIDIA开源为学术界提供了可验证的系统变量:
| 组件 | 是否开源 | 说明 |
|---|---|---|
| Nemotron 3 Ultra weights | 是 | 通用版底座模型 |
| SFT checkpoint | 是 | 监督微调专家 |
| RL checkpoint | 是 | 强化学习专家 |
| 训练数据(SFT/RL) | 是 | 完整证明轨迹与反馈 |
| 推理代码 | 是 | proof pool与refinement逻辑 |
| nemotron-imo-bench | 是 | 200道新测试题 |
| 部分teacher checkpoint | 否 | 未逐阶段复现 |
| MOPD checkpoint | 否 | 未开放 |
这为研究者提供了调整变量Space:checkpoint组合、sampling budget、verifier threshold、refinement depth。
读者落地建议
- 适合谁用:具备多个A100/H100/B200 GPU节点的研究团队,可在此框架上迭代验证器模块或适配新题型;
- 谁该再等等:单实验室GPU资源不足百卡者,应关注未来是否出现更小规模可复现版本,或利用云厂商的分时租用服务。
写在最后
英伟达的开源不是终点,而是新竞赛的起点。当生成能力成为可复制的"标配”,真正的护城河将转向验证器的独立性设计与错误栏位的交叉覆盖能力。算力民主化的承诺诚然可贵,但若验证者共享同一套思维牢笼,再多的算力铺陈也将困于同一片盲区。