
高通发布第六代骁龙8超级至尊版:专为智能体AI重构计算平台
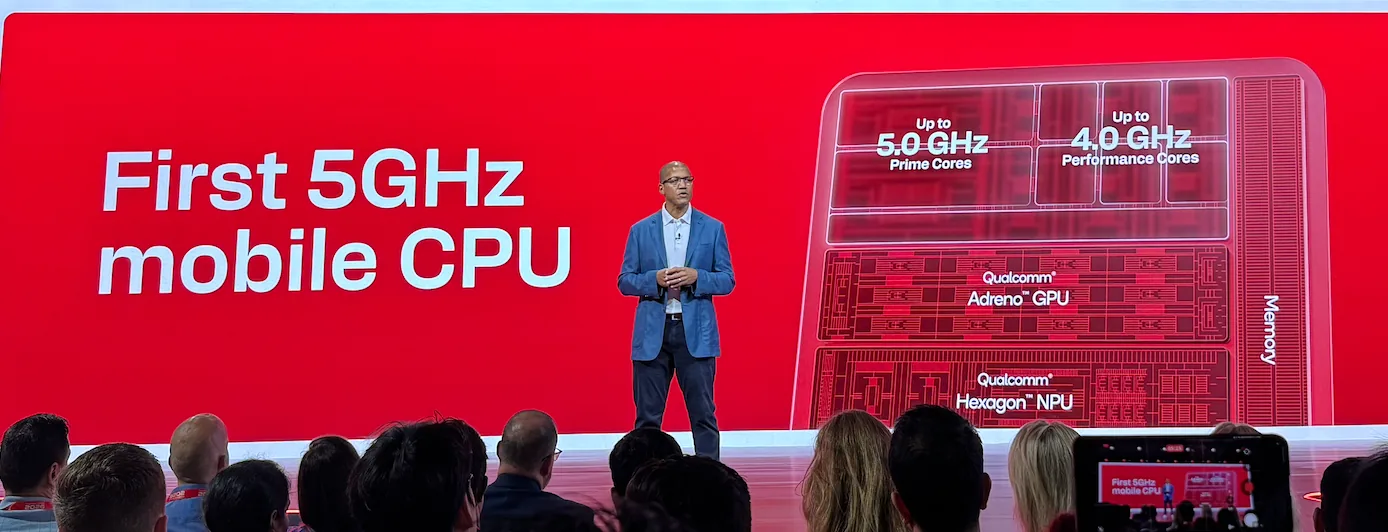
高通在骁龙峰会上正式发布第六代骁龙8超级至尊版与第六代骁龙8至尊版两款2nm制程移动旗舰平台。根据官方信息,超级至尊版位于产品组合顶端,拥有业界首个最高主频达到5GHz的移动CPU,可端侧运行300亿参数MoE模型,支持高达32K Token的上下文长度。目前两款平台已发布,具体上市时间和定价未在材料中披露,开放性方面未提及是否向特定厂商优先供货。
打破内存墙:从片上缓存到系统存储的协同设计
智能体AI全天运行面临的核心挑战并非峰值性能,而是内存墙与功耗限制。高通在超级至尊版上采取系统级优化策略:
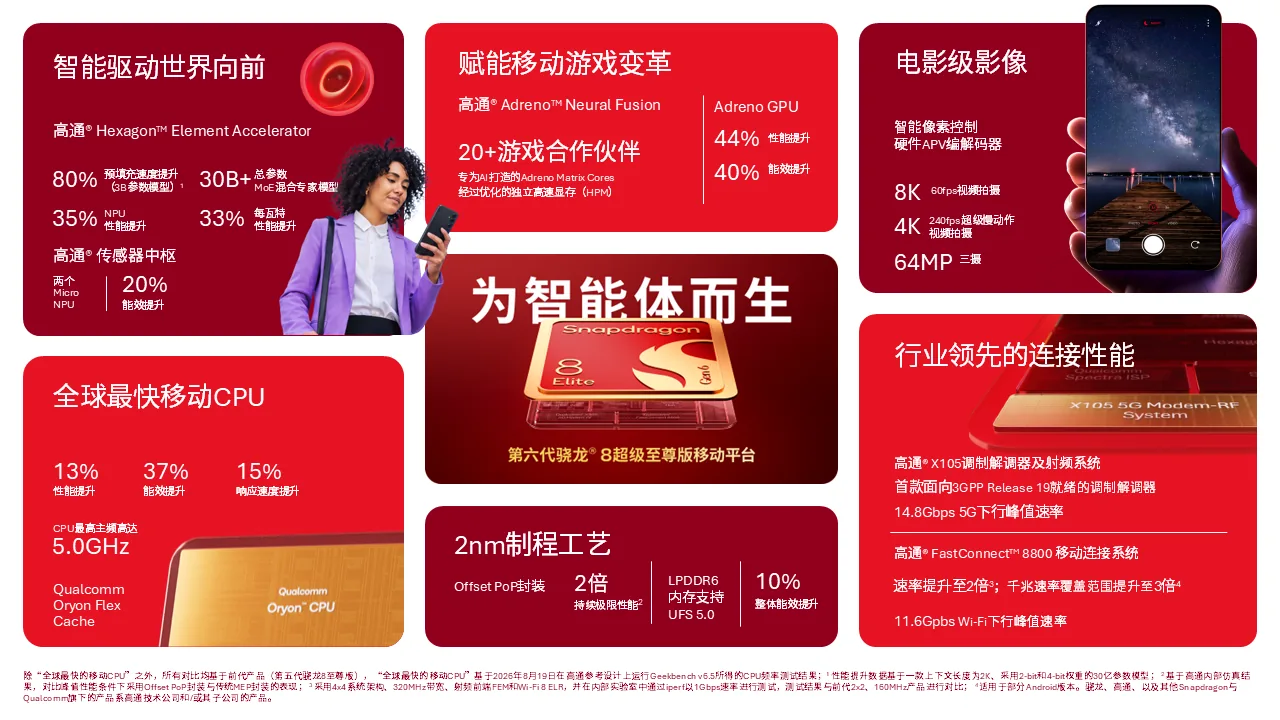
- Oryon CPU引入全新Oryon FlexCache,让8个核心共享同一L2缓存池,动态分配资源以减少任务切换等待时间
- Adreno GPU配备第二代18MB独立高速显存HPM,减少对系统内存的反复访问,实现功耗降低12%
- Hexagon NPU共享内存增加50%,使模型状态与KV-cache更多留在片上
- 搭载LPDDR6内存与UFS 5.0闪存,实现从片上缓存→系统内存→闪存的三级数据调度
值得注意的反差在于:300亿参数MoE模型的实际激活参数仅约30亿,这一设计巧妙平衡了模型容量与端侧资源限制——高通产品技术专家朱元堃指出,端侧智能体的主要瓶颈实为内存与续航,而非纯粹算力。
异构计算协同:CPU/GPU/NPU重新分工
第六代骁龙8超级至尊版首次在Adreno GPU中加入Matrix Cores(矩阵核心),这是骁龙平台首次将AI能力集成进图形管线。该设计带来两个关键变革:
- GPU.Matrix Cores可直接处理超级分辨率、帧生成等AI任务,无需数据离开GPU交付NPU
- 游戏开发者可调用GPU中的AI能力,NPU更适合运行大型持续模型,CPU专注智能体编排
NPU层面还加强了对Transformer的支持:Hexagon Element Accelerator针对关键运算优化,使预填充性能提升最高80%;传感器中枢则部署双Micro NPU,性能提升85%同时功耗降低20%,支持以较低功耗持续处理语音与活动数据。
| 特性 | 第六代骁龙8超级至尊版 | 第六代骁龙8至尊版 |
|---|---|---|
| CPU主频 | 业界首个5GHz | 未披露 |
| GPU AI核心 | 首次加入Matrix Cores | 未披露 |
| NPU能力 | 运行300亿参数MoE模型 | 未披露 |
注:至尊版详细参数未在原始材料中披露
从单次问答到持续工作流:端侧AI落地场景
高通与阶跃、无量火、江波龙合作,成功将StepEdge-Omni 30B-MoE完整部署于手机端。通过异构调度与存算协同,模型运行内存需求较常规方案降低超过50%,预填充速度超过330 Token/s,解码速度超过28 Token/s,可完成邮件理解、行程规划、日历同步、航班酒店推荐及邮件草拟等连续任务。其中NPU与GPU双引擎协同使预填充吞吐性能相较仅用NPU方案提升超30%。
这些能力支撑起三大实际体验方向:
- 办公场景:传感器中枢持续整理个人知识图谱
- 游戏体验:Adreno Neural Fusion加速帧生成与超级分辨率
- 影像系统:第二代AI-ISP首度支持8K 60fps视频拍摄,将视觉数据转化为多模态模型可理解的上下文
读者落地建议
- 适合哪类用户:追求端侧大模型实时响应、重视隐私保护、且需要跨设备智能体连续体验的高端旗舰用户
- 建议观望的用户:对300亿参数模型没有刚需、更关注游戏峰值性能而非持续AI任务的用户,至尊版可能提供更平衡选择
写在最后
智能体时代,旗舰SoC的竞争标准正从峰值性能转向系统级能效比与多模态任务协同能力。高通的这次重构并非单纯堆叠算力,而是以内存调度、异构协同与场景闭环为新的性能标尺——这或许标志着移动AI进入务实落地的新阶段。