发布动态:同日发布,定位升级
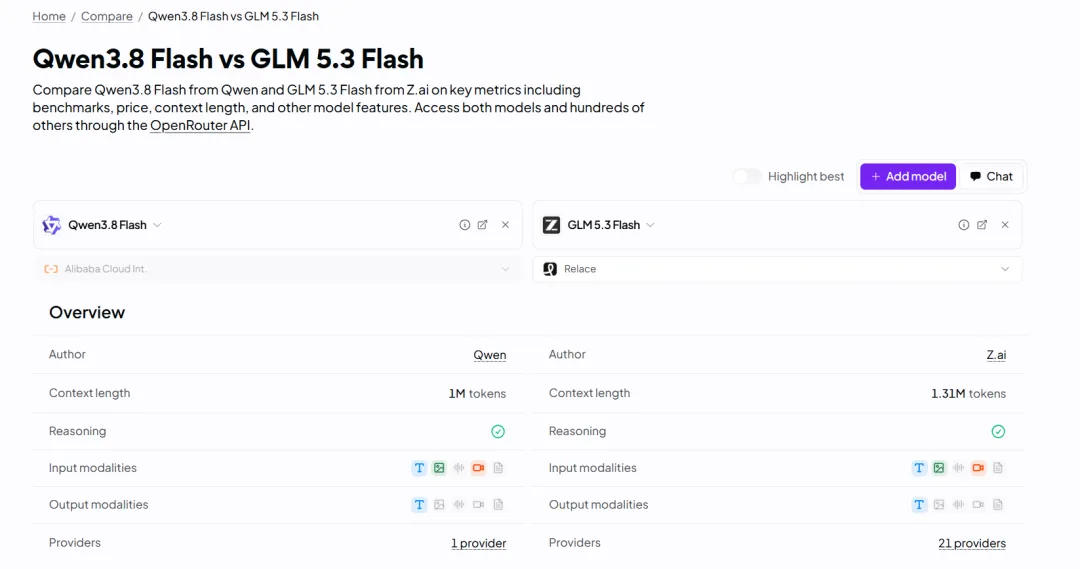
2026年8月26日,阿里巴巴千问云与智谱AI同步发布新一代Flash系列大模型:Qwen3.8-Flash(及Flash-Next版本)、GLM-5.3-Flash。此次发布标志着Flash产品的战略升级——不再仅作为低价补位产品,而是直接切入办公、开发和交付物生成等真实高频场景。
核心事实要点如下:
- 发布时间:2026年8月26日
- 新版本:Qwen3.8-Flash、Qwen3.8-Flash-Next;GLM-5.3-Flash
- 价格定位: Flash模型显著低于旗舰版,本次实测Qwen3.8-Flash任务成本约6.26元,GLM-5.3-Flash约7.72元
- 可用性:已开放调用(实测在Claude Code中完成)
- 权重开放:Qwen3.8-Flash-Next为开源版本,可作为架构参考;GLM-5.3-Flash未明确是否开源
实测对比:工程完整性 vs 工作流理解
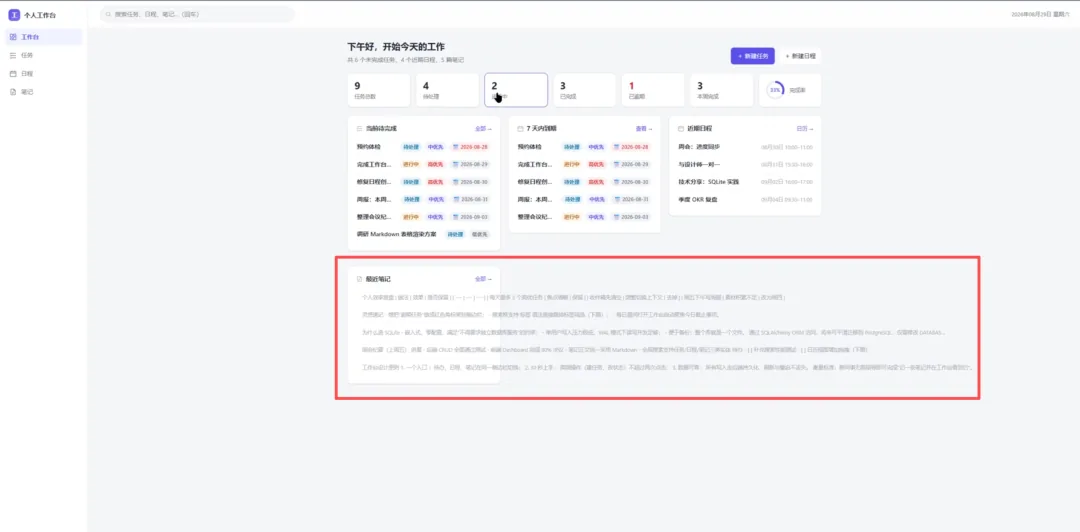
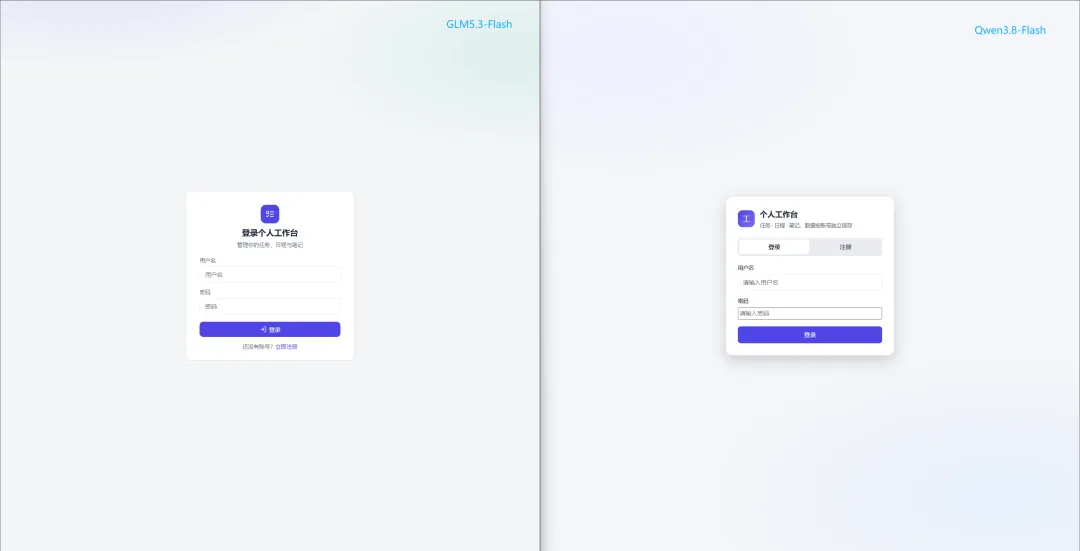
为验证模型能力,测试团队在相同环境下要求二者开发一个完整可运行的个人工作台Web应用,涵盖任务管理、日程管理、笔记管理、Dashboard和全局搜索功能,要求具备真实后端逻辑与数据持久化。
测试采用两轮模式(首轮生成+自优化),结果呈现明显路径差异:
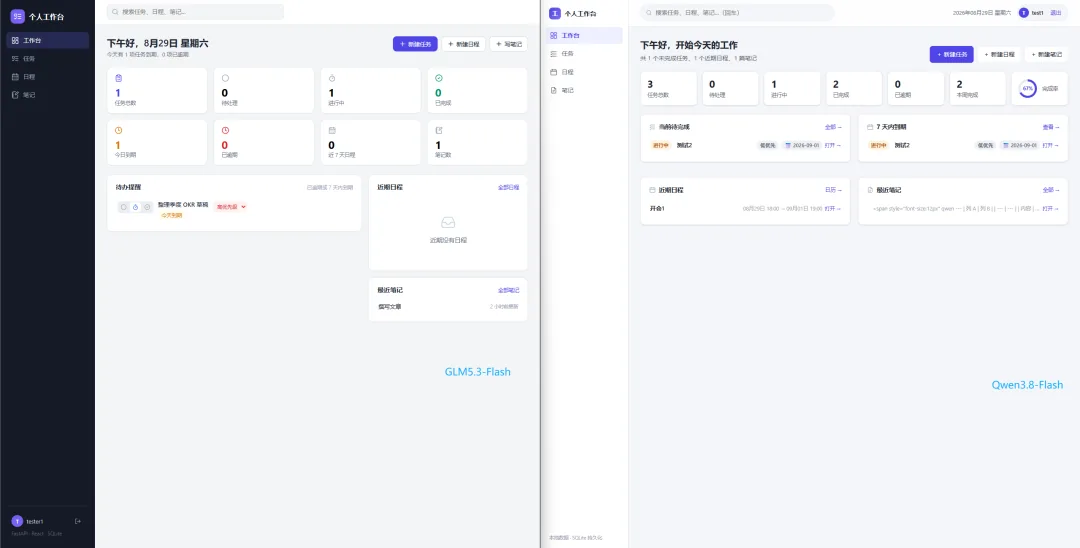
- GLM-5.3-Flash更偏向工程交付型:快速补齐登录注册、模块导航、CRUD接口、统计卡片等完整SaaS系统骨架,系统边界清晰、模块独立性强;
- Qwen3.8-Flash更早切入个人工作节奏:任务页集成智能排序、逾期提醒、7天内到期视图;笔记模块支持Markdown预览、标签分类与工具栏;首页围绕“当前待完成”和“7天内到期”组织信息流。
意外反差数据:GLM-5.3-Flash虽参数规模更高(总参数约320B,激活参数18B),但在本次任务中工具调用次数、输出Token量、LLM调用频次(123次)均高于Qwen3.8-Flash,反映出其倾向于“先搭全蔽,再优化”的工程惯性;而Qwen3.8-Flash(激活参数仅6B)以更轻量的执行路径达成任务目标。
关键参数与能力对比
| 维度 | Qwen3.8-Flash | GLM-5.3-Flash |
|---|---|---|
| 主模型规模 | 125B(激活6B) | 约320B(激活18B) |
| 技术辅助 | 51B N-gram Embedding + 4B MTP扩展 | Sparse + Linear Attention混合结构 + 专家池 |
| 上下文支持 | 1M tokens | 官方未明确,实测中上下文控制较收敛 |
| 适配场景 | 办公任务处理、Coding、多模态 | Toolathlon(工具调用)、Terminal-Bench(终端Agent) |
| 单次任务成本 | 约6.26元 | 约7.72元 |
谁该优先尝试?
根据模型特性与实测表现,推荐如下:
适合直接上手Flash模型的场景:
- 日常高频办公任务(任务规划、日程跟踪、会议纪要沉淀)
- 个人效率工具或轻量级SaaS原型开发
- 需要长上下文处理(1M tokens)的文档分析与代码库漫游
- 对成本敏感、追求稳定服务可用性的企业级应用
建议继续等待或选用旗舰模型的场景:
- 高复杂度推理任务(金融研究建模、多步骤复杂决策)
- 对UI细节完美度要求极高的交付物生成
- 需要强工具链整合与Agent自主任务拆解的复杂流程
写在最后
Flash模型正从“副驾驶”驶向“驾驶位”,其价值已从单纯降本转向重构日常生产力的工作流设计逻辑。未来办公场景的主力模型,未必是参数最大的那个,而是最懂高频工作节奏、且服务成本可控的那个。