
持续进化的技术信念:从端到端到自我进化
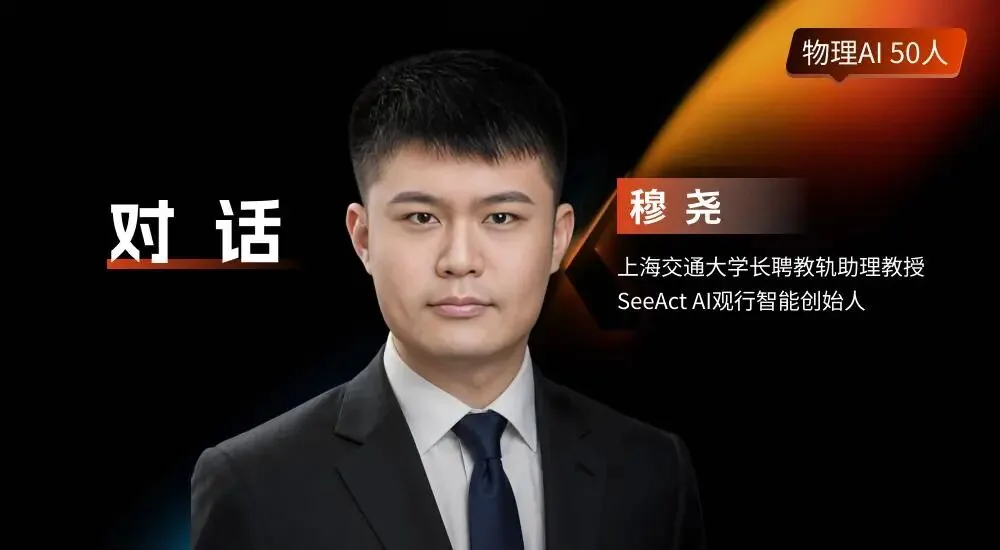
具身智能学者穆尧于2026年正式创办SeeAct AI观行智能,聚焦"具身自我进化"方向。这一选择与其2018年清华硕士阶段坚持的端到端Policy和奖励驱动理念一脉相承。穆尧现任上海交通大学长聘教轨助理教授,入选国家级青年人才计划,谷歌学术引用超5000次。其主导的RoboTwin已成为中国具身智能领域的事实标准之一,GitHub收获超2900颗星,蚂蚁集团LingBot-VA、生数科技Motubrain等均在此基准上刷新成绩。
核心判断:具身智能的终局一定会迈向奖励驱动的自我进化。 穆尧指出,机器人真正缺的不是数据而是经验。仅靠人类演示的数据训练出的模型,仅知道"人在这种情况下会怎么做",却无法积累"自己在同样情况下失败后如何调整"的实际经验。这些经验需通过与环境的持续交互、自主试错与反馈分析来获得。
Experience Scaling:经验规模化是真正的Scaling杠杆
穆尧提出具身智能Scaling需三层共振:
- Data Scaling:扩大训练数据规模
- Model Scaling:扩大模型参数规模
- Experience Scaling:经验规模化——这是目前所有研究中普遍不足的关键维度
经验规模化包含三个维度:
- 交互数量的增长
- 经验覆盖场景与任务广度的扩展
- 经验对能力提升的实际价值深化
其核心在于建立一种能够持续产生经验的机制:当机器人遇到新问题时,可自主探索并将尝试过程与结果积累下来,供后续学习复用。随着能力提升,系统还能接触更复杂任务,形成正向循环。
递归自我进化:能力与经验的滚雪球式增长
穆尧进一步提出"递归自我进化"(Recursive Self-Improvement)概念:能力提升后,系统可产出更高质量的经验;这些新经验又继续反推能力升级,形成滚雪球效应。
以拧瓶盖任务为例,完整自主纠错流程包括:
- 预训练阶段积累处理摩擦力变化、抓取角度偏移等边缘情况的经验
- 后训练阶段面对全新物体(如无把手的黑色冰箱),能自主尝试:“左边打不开就试右边”
- 系统需懂得在无效尝试上停止(如掰不动时不持续施加百牛力矩以免损坏设备)
关键点在于:一次交互的收获必须能被保留并用于后续任务,这才是"进化"而非简单数据驱动学习。
架构实践:从RoboTwin到dVLA-RL的系统演进
穆尧的研究路线呈现清晰脉络:
- RoboTwin 1.0(2021年起):轻量级仿真引擎,支持学生在游戏本上运行完整仿真流水线
- RoboTwin 2.0(2023年后):任务规模扩展至50个,强化行为与代码生成能力,定位为Benchmark与数据生成器
- RoboTwin 3.0(2025年起):与摩尔线程合作,支持国产显卡与国产物理引擎,强调生态开放性
- VLA与Agent System:从代码生成转向端到端策略基础模型,最终形成上层Agent推理+底层端到端Skill调用的完整架构(如与智元合作的RoboClaw)
- dVLA-RL:基于离散扩散VLA的多任务强化学习框架,解决单一场景微调后泛化能力退化问题
在模型选择上,穆尧团队发现离散扩散模型兼具复杂动作轨迹生成能力与策略优化简易性——其词元预测机制可直接适配PPO、GRPO等强化学习算法,比连续扩散/流匹配路线更适合后续奖励驱动学习。
落地路径:虚实协同的经验规模化策略
面对真实世界试错成本高昂的限制,穆尧提出虚实协同的经验规模化方案:
真实数据与仿真数据并非二元对立,而是三个"平行宇宙"的数据融合:
- 真机自主交互数据(无sim-to-real gap)
- 物理引擎生成数据
- World Model/World Engine生成数据
关键配比动态变化:取决于当前模型能力短板(如背景泛化差则增补仿真增广数据;高精度物理接触任务则依赖真机反馈)
部署阶段策略:大量试错在虚拟空间完成;真实世界仅提供关键物理反馈与分布外场景验证
值得注意的反差数据
尽管行业2024-2025年频繁强调"数据短缺",穆尧指出当找到合适数据采集范式(如UMI、手持夹爪)后,百万小时数据采集速度远超预期。真正瓶颈已从数据获取转向经验生成机制的构建——这正是Experience Scaling与Self-Evolution的核心命题。
读者建议
适合关注的群体:
- 从事具身智能算法研究的工程师:RoboTwin系列工具提供现成Benchmark支持
- 计划布局机器人长期自主能力的企业:穆尧强调的"奖励驱动+递归进化"路线需提前布局基础模型与仿真生态
- 研究强化学习落地的团队:dVLA-RL框架对多任务联合训练有实际参考价值
建议再等等的群体:
- 对即用性有极高要求的工业场景:当前阶段仍需解决Sim-to-Real gap与自主纠错可靠性,离工业级99.99%成功率尚有距离
写在最后
穆尧的理论体系将具身智能从"数据驱动"推向"经验驱动"新阶段,其递归自我进化框架为长期自主能力提供了可操作路径图。当大模型的通用能力问题初步解决后,让机器人真正"长出"自我进化能力,或将成为下一步竞争焦点。