
上一篇拆了《首尔今天有点鲁》的制作链路,评论区最多的一类反馈是"道理懂了,上手还是懵"。这篇把那套 3 小时 12 分钟的保姆课直接拆成 14 张图——每张图对应一个上机动作,参数和提示词都从视频里逐帧抄录,照着做就能从零走到成片。
先给全流程骨架,心里有地图再上路:
剧本(3+3+3法则)→ 资产设计(三视图+道具产品图)→ 分镜(幕/场/节拍)→ 提示词(RTCF框架+运镜语言)→ 视频生成(多图参考+全图参考模式)→ 剪映二次剪辑
第一步:认识两件武器
即梦是字节官方的创作台,Seedance 2.5 是它的旗舰视频模型;LibTV 是套在多家模型外面的节点式工作台,核心卖点是"多图参考"——把角色图、场景图、道具图全部挂进画布,生成时用编号互相引用,这是后面一切角色一致性的基础。
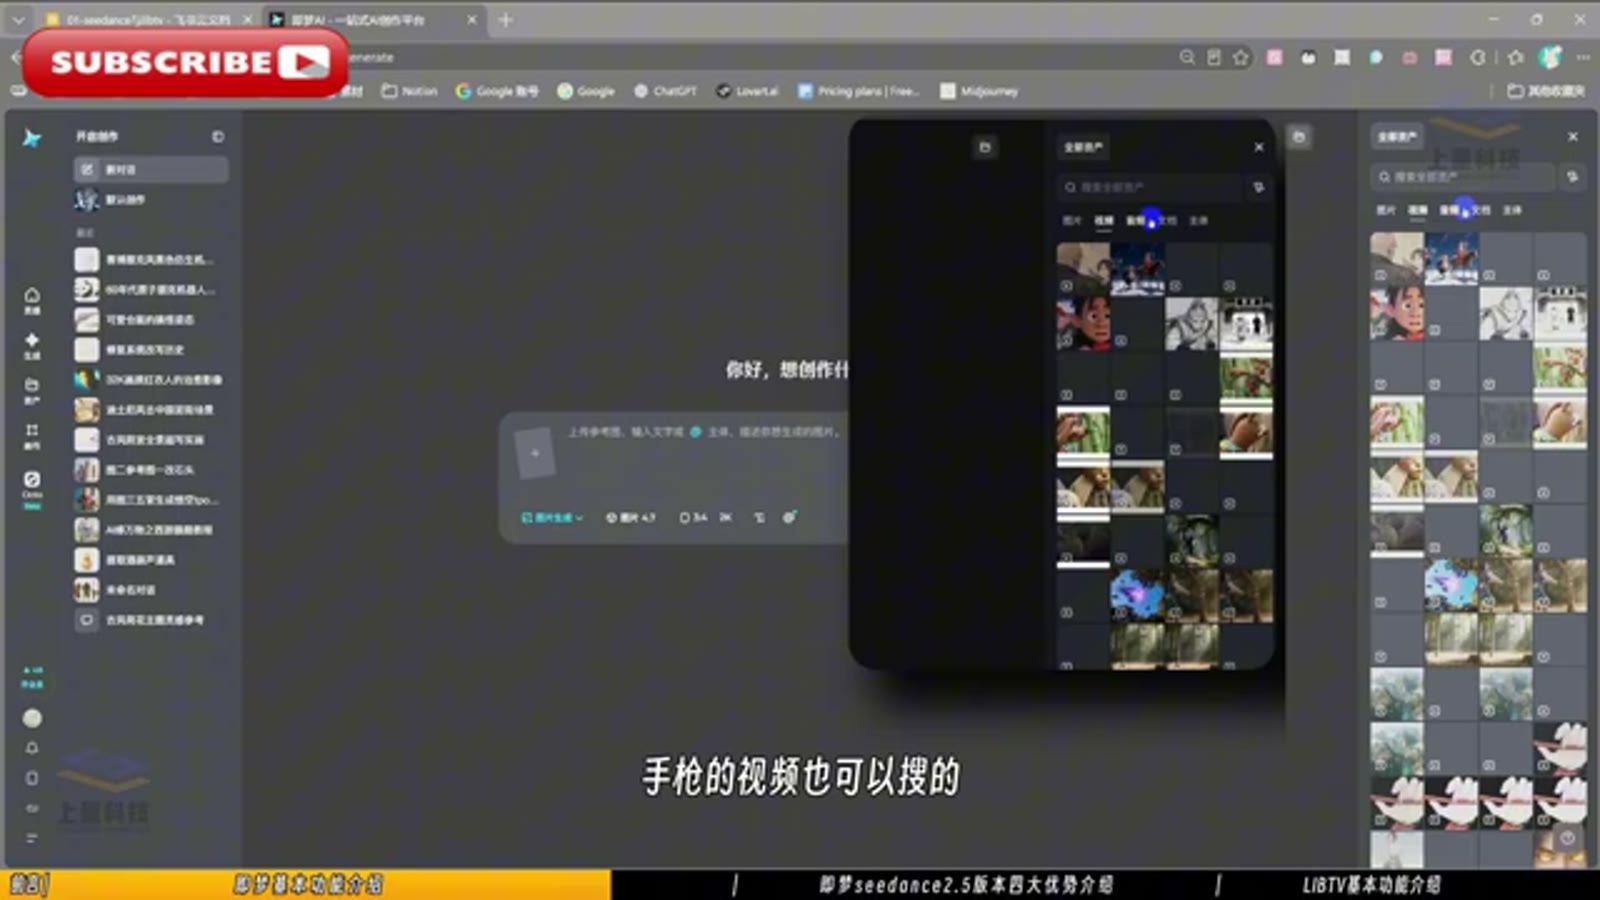
教程里演示的第一个动作很朴实:在素材库里搜参考视频。讲师原话"手枪的视频也可以搜的"——找参考是全流程的起点,先看别人怎么拍,再决定自己怎么生成。
第二步:用一段提示词把故事变成剧本
这是全课最值得抄的一段。讲师没有手写剧本,而是给 DeepSeek 发了一段结构化指令:
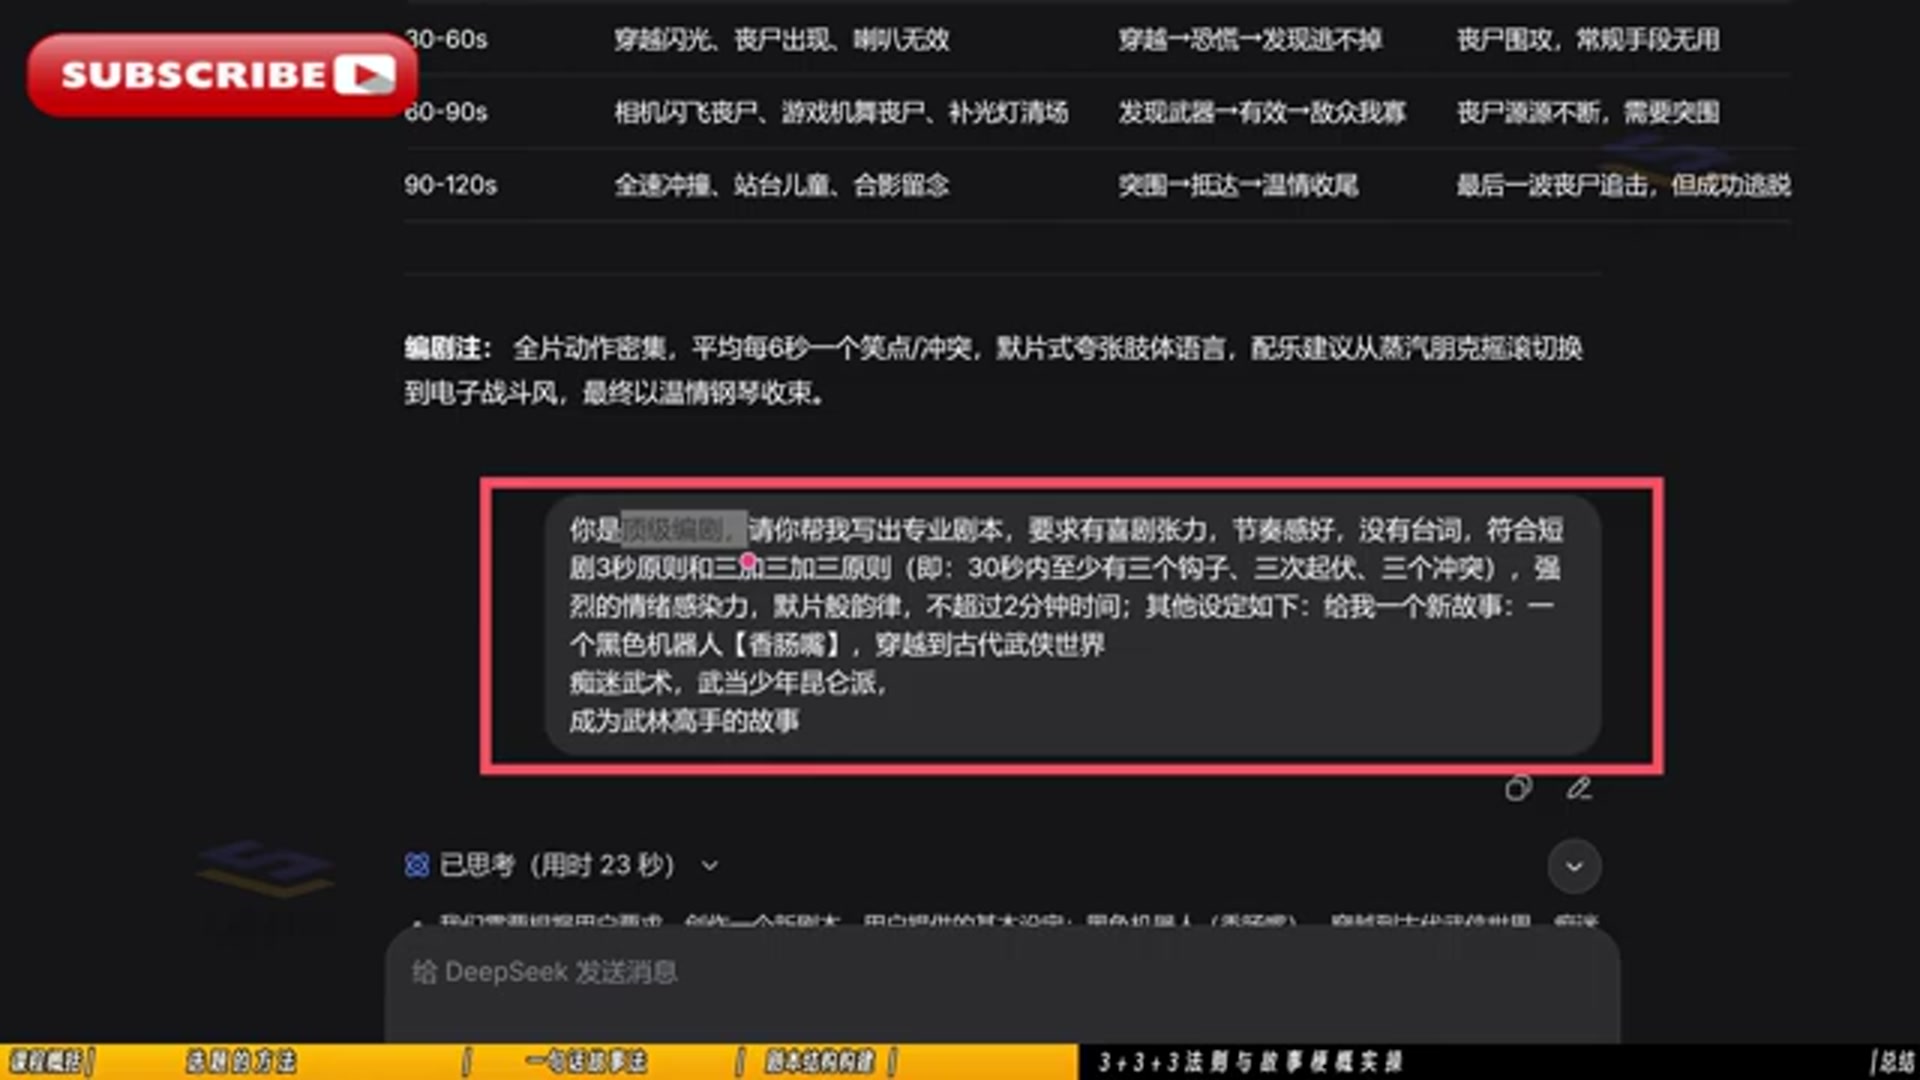
你是顶级编剧,请你帮我写出专业脚本,要求有画面张力,节奏感好,没有台词,符合短剧3秒原则和三幕加三原则(即:30秒内至少有三个钩子、三次起伏、三个冲突),强烈的情绪感染力,影片般的剧情,不超过2分钟时间。
“3+3+3"就是短剧剧本的骨架:30 秒内 3 个钩子留住手指、3 次起伏推着情绪走、3 个冲突制造期待。机器人生成的剧本拿回来后是一张分镜表:
四列结构直接可抄:时间段 / 内容动作 / 情节推进 / 冲突结果。每 30 秒一行,编剧注写节奏要求(这套示例的注是"平均每 6 秒一个笑点/冲突,默片式夸张肢体语言”)。注意"没有台词"这个设定——AI 短剧的对白靠后期配音,剧本阶段只需要画面。
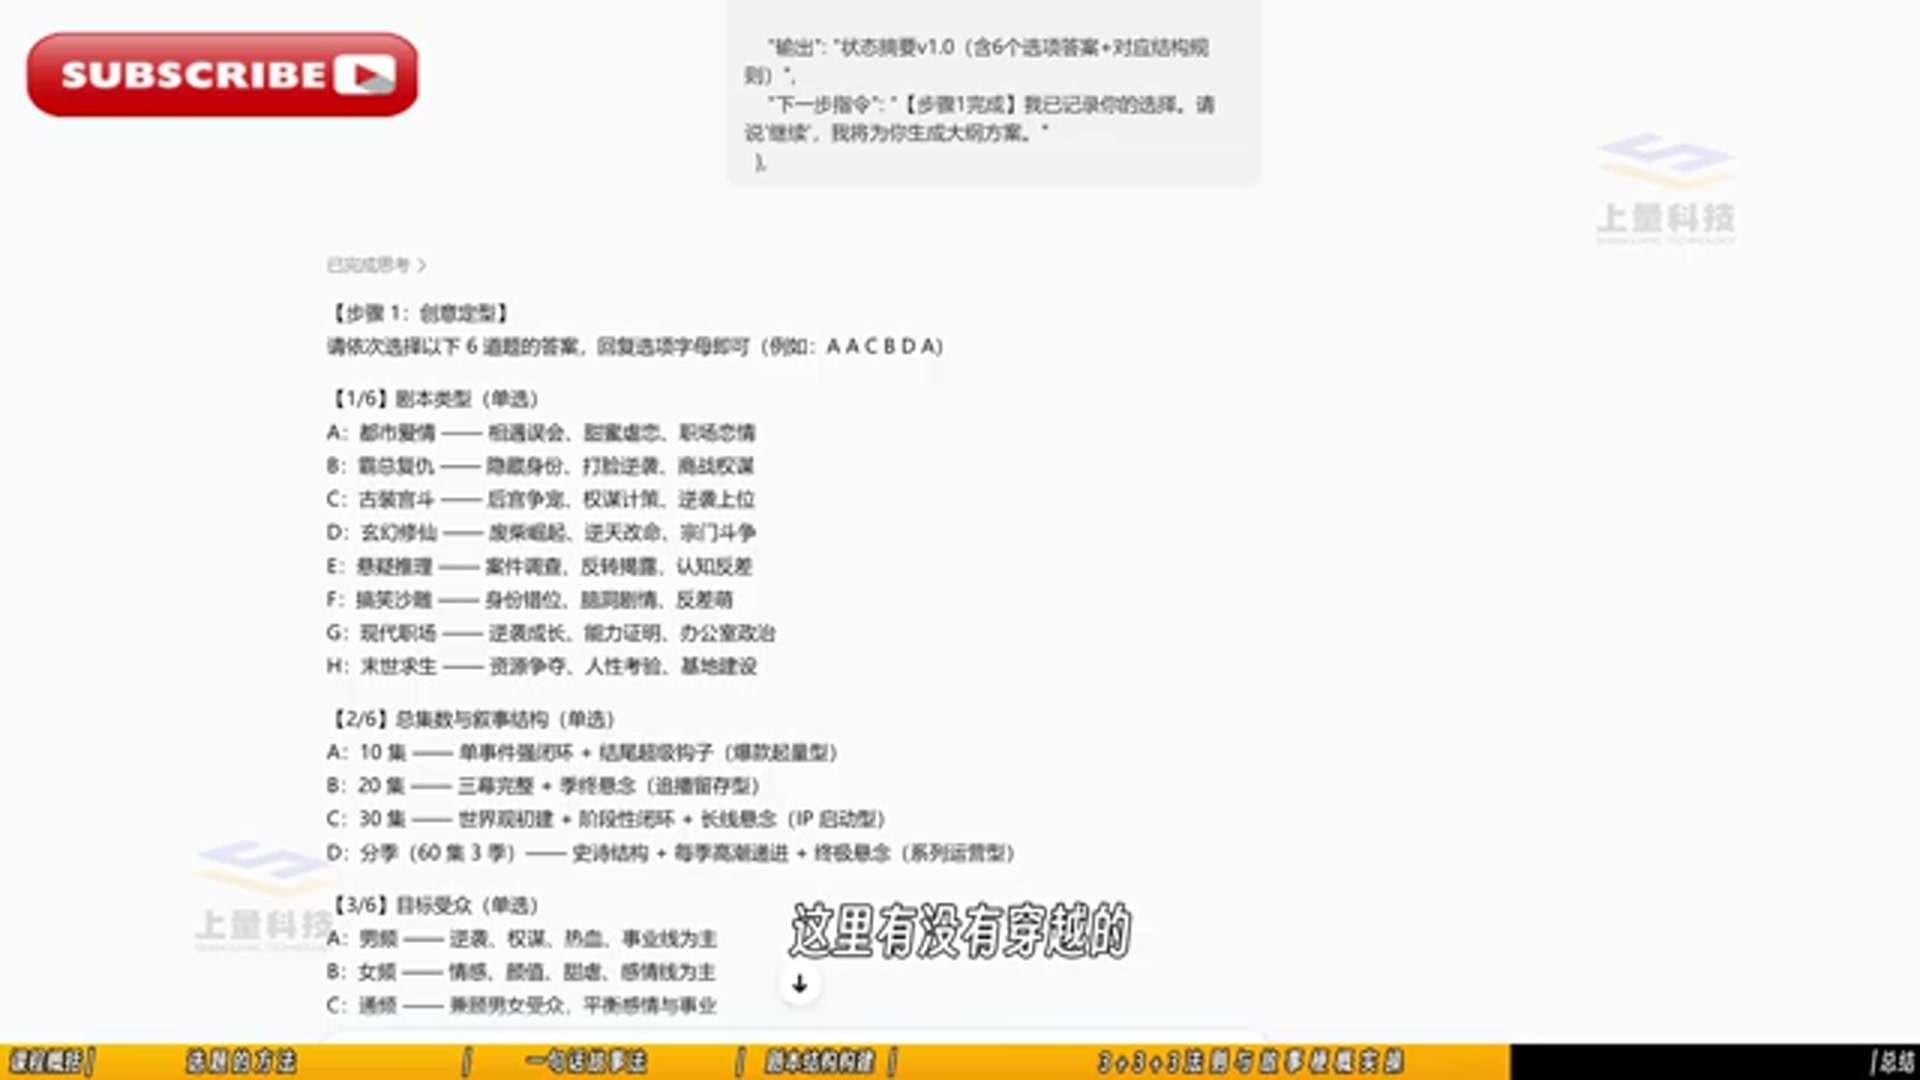
讲师和模型的配合方式也值得学:不是一次性要完整剧本,而是让 AI 先给 6 个方向的选择题,人选定一个再说"继续",逐层收敛。这比一句"给我写个剧本"可靠得多。
第三步:把剧本拆成四类资产
很多人拿到剧本就开始生视频,教程在这里踩了刹车:先做资产。四类拆法——主角资产、配角/群像资产、场景资产、道具资产——每类都有专属提示词模板。
道具走"产品图"路线,模板逐字可抄:
〔物品名〕产品摄影,〔形体描述〕,〔材质细节〕,纯白背景 #FFFFFF,正面均匀柔光无阴影,UE5 引擎 3D 写实,真实〔材质〕纹理,8K 超高清
用教程里的"青铜古钥匙"填一遍:圆形钥匙直径约 20cm,青铜质感锈迹花纹,边缘带符号装饰痕迹,古朴厚重质感——后半段固定词原样粘上就是一条合格的产品图提示词。场景走"空镜"路线,模板同样固定:无人场景 + 环境描述 + UE5 3D 写实 + 8K。
角色设计还有个前置于工具的方法论:
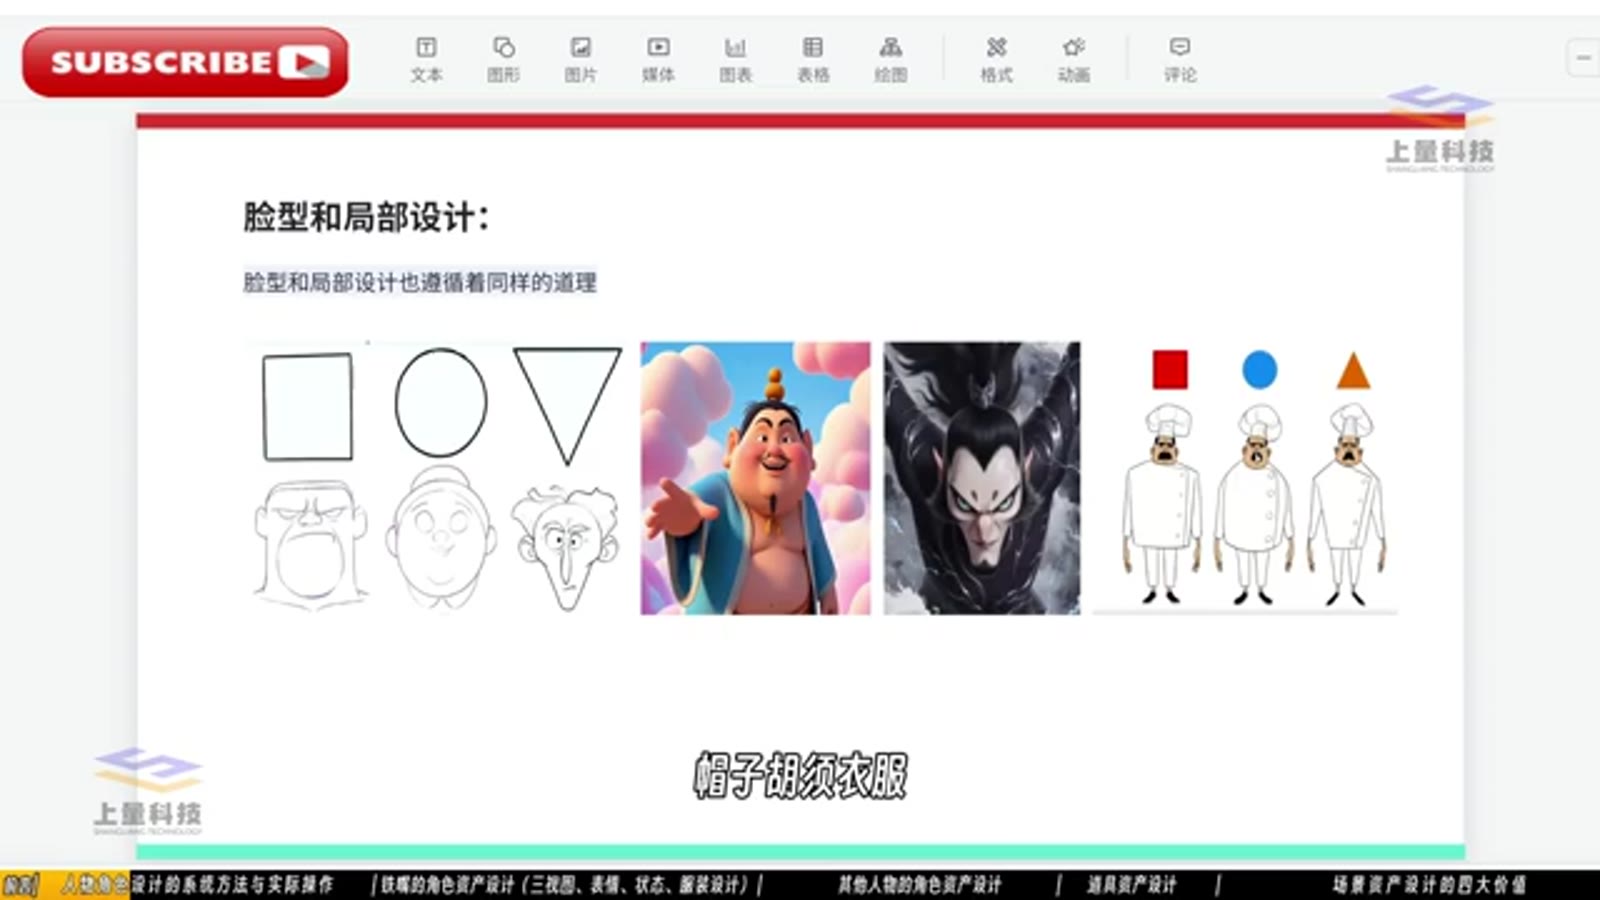
用圆、方、三角三种基础几何形状统一控制角色的脸型、体型和局部特征——帽子的形状、胡须的走向、衣服的轮廓都跟着主角的几何属性走。反派用尖锐三角形,憨角用圆形,观众在看到脸之前就已经"读懂"了角色。
第四步:LibTV 的杀手锏——角色三视图
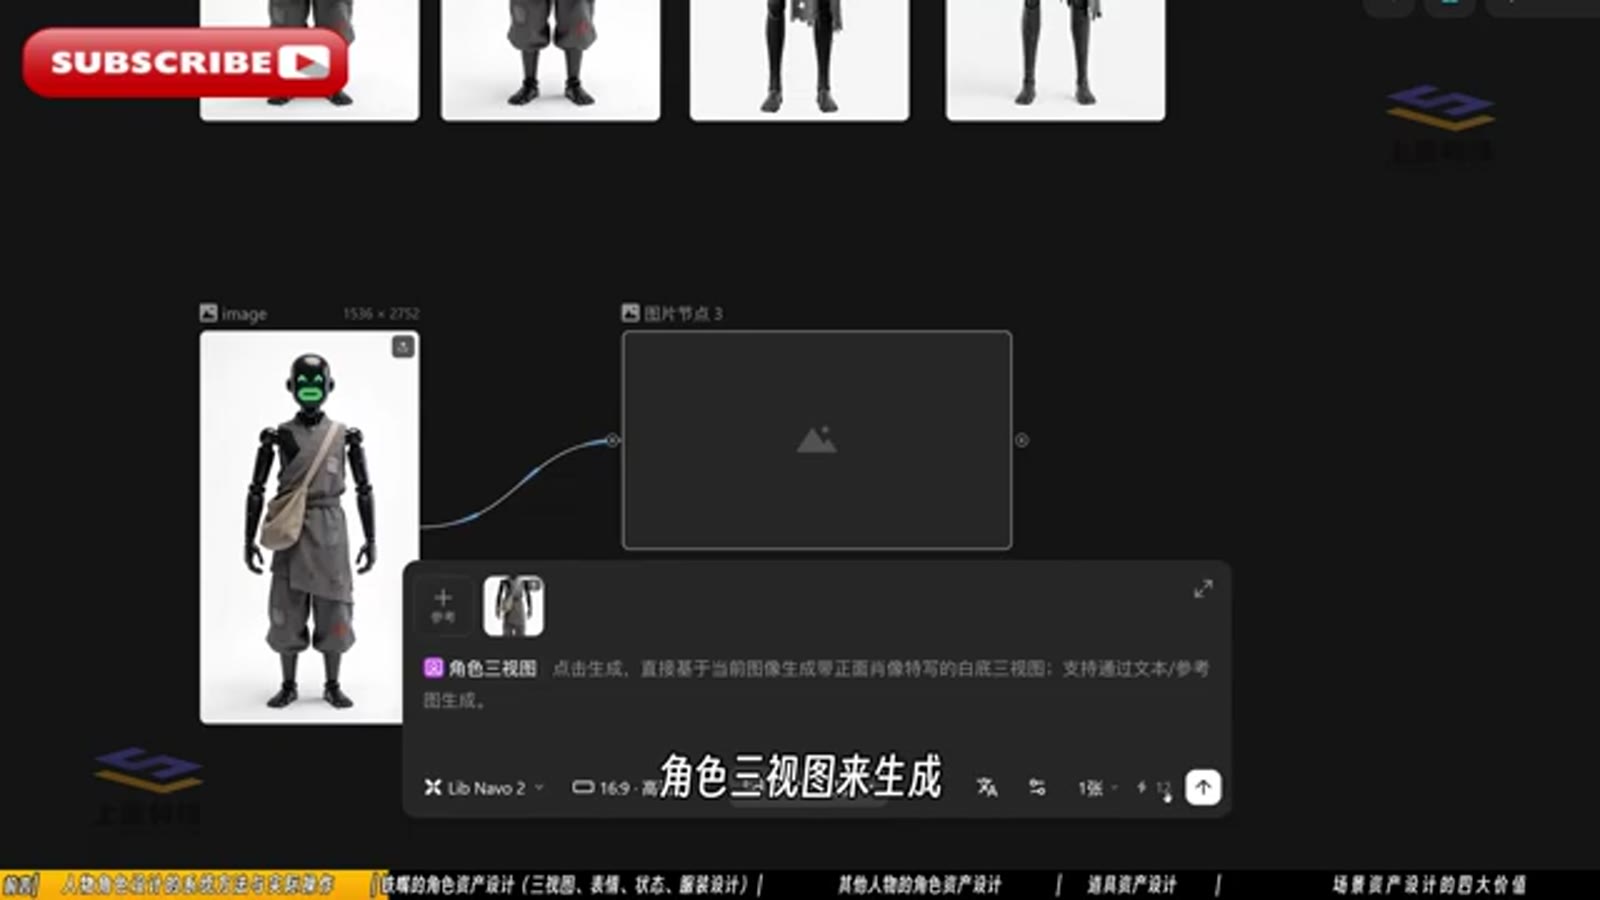
在 LibTV 画布里放一个图片节点装角色参考图,连到生成节点,选择"角色三视图"模板。功能说明原文:
点击生成,直接基于当前图像生成正面/背面/仰45°的白底三视图;支持通过文本/参考图生成。
参数:模型 Lib Nawo 2,画幅 16:9。这一步是角色一致性的地基——三视图生好后,后续所有镜头生成时把三视图挂为参考图,角色外观就不会漂。
章节内容里角色资产细分为低成本角色(三视图/表情/状态/服装)、拟人化角色、群组人物三条路线,加上道具与场景,凑齐"资产四大件"。
第五步:分镜之前,先懂剧的结构
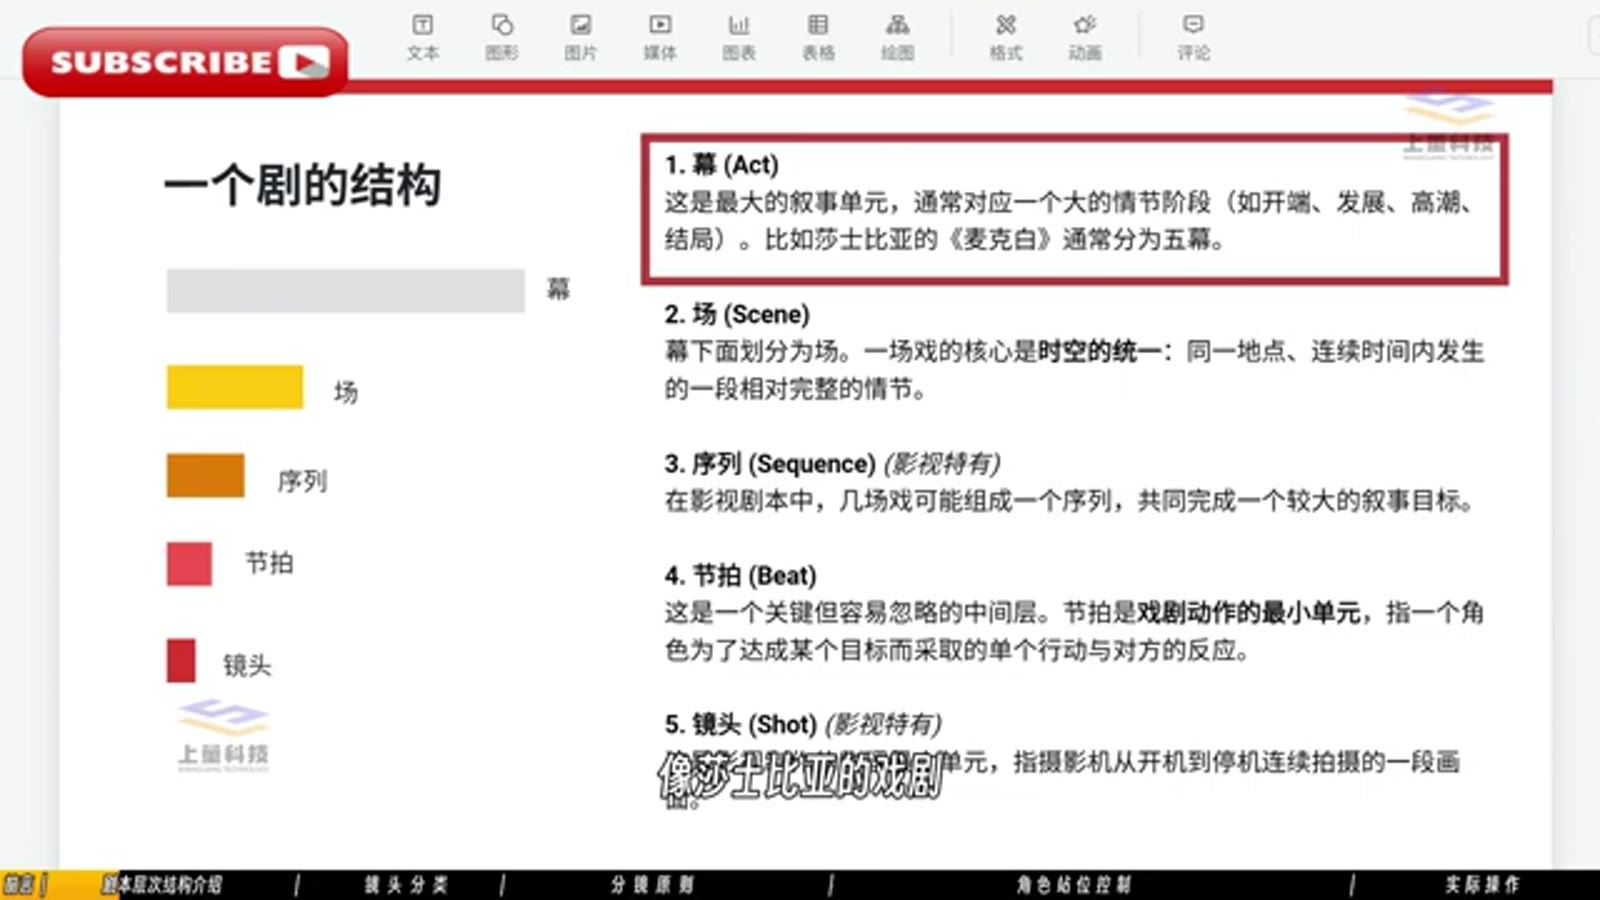
幻灯片原文的五层:幕(Act)→ 场(Scene)→ 序列(Sequence)→ 节拍(Beat)→ 镜头(Shot)。最容易被忽略的是节拍——“一个角色为了达成某个目标而采取的单个行动与对方的反应”。分镜表里的每一行,本质都是一个节拍。
落到操作上,是把分镜提示词整理到画布:
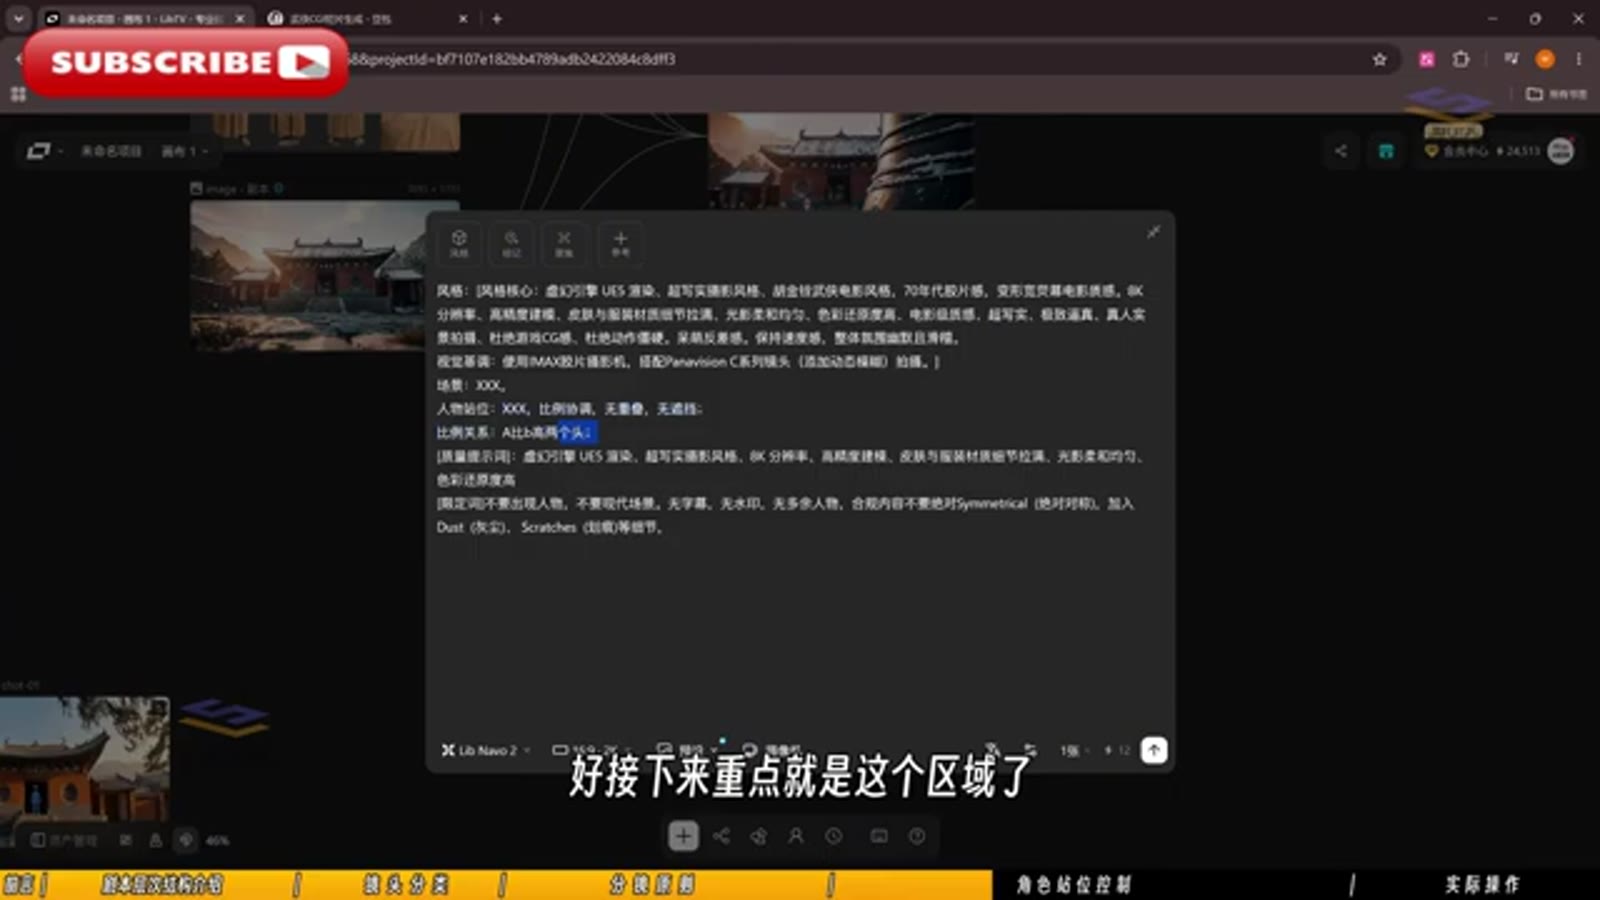
左列场景参考图、右列生成结果,节点间连线,滚轮推拉缩放。分镜阶段的产物是一排"定场节点",每个节点自带分辨率标记(1280×720 即 720P 目标)。
第六步:提示词的 RTCF 框架与运镜语言
RTCF 四要素在幻灯片页脚里给了完整清单:画面美学(风格、构图、视距、视角、景别、光线、色调)。教程把这串词拆成六张"视角"卡逐一示范:
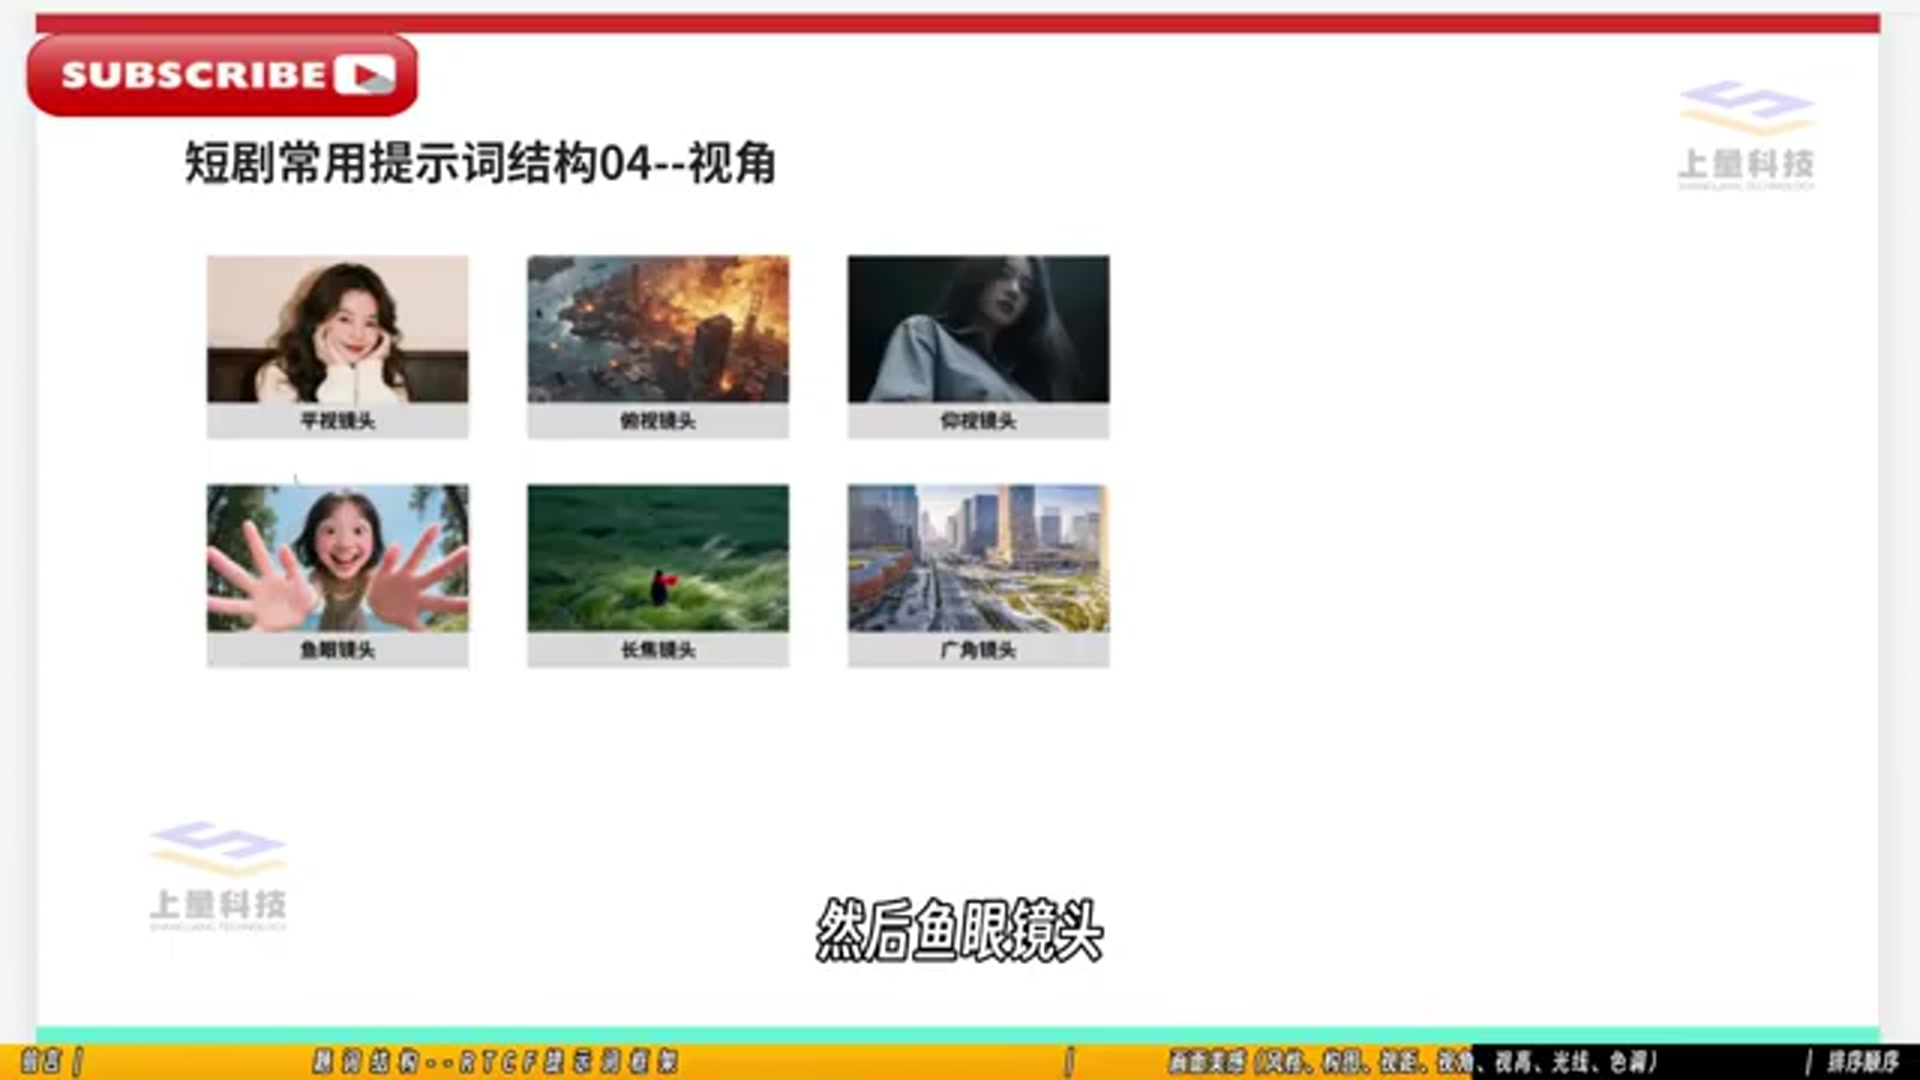
平视、俯视、仰视、鱼眼、长焦、广角——每种视角配一张示例图。写提示词时视角词必须显式出现,“鱼眼镜头"四个字比"夸张变形"有效得多。
生图实测帧里的完整示例可以感受密度:
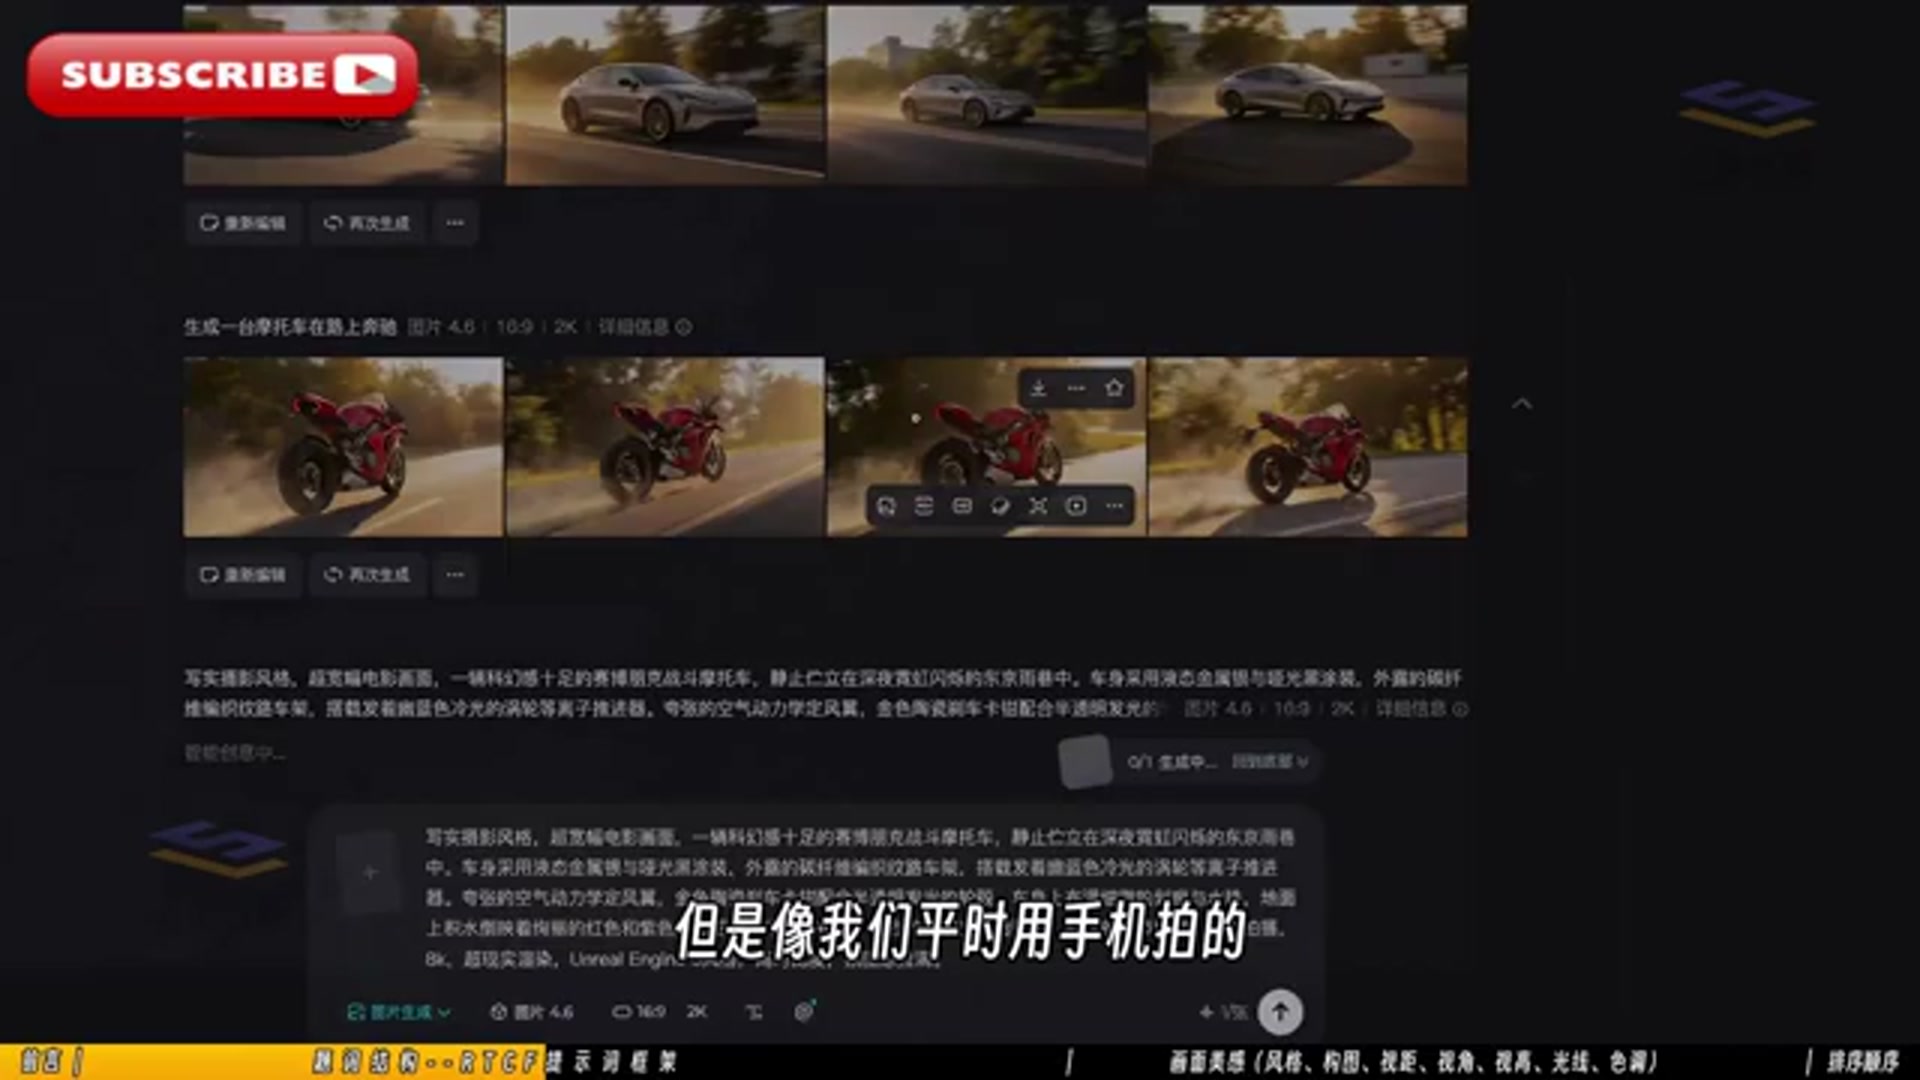
写实摄影风格,超高清电影画面,〔主体〕,〔环境〕,8K,超现实渲染,Unreal Engine——风格词、画质词、引擎词一个不落。AI 不猜,全靠喂。
第七步:视频生成的多图引用
到视频生成节点,前面所有资产在这里汇合:
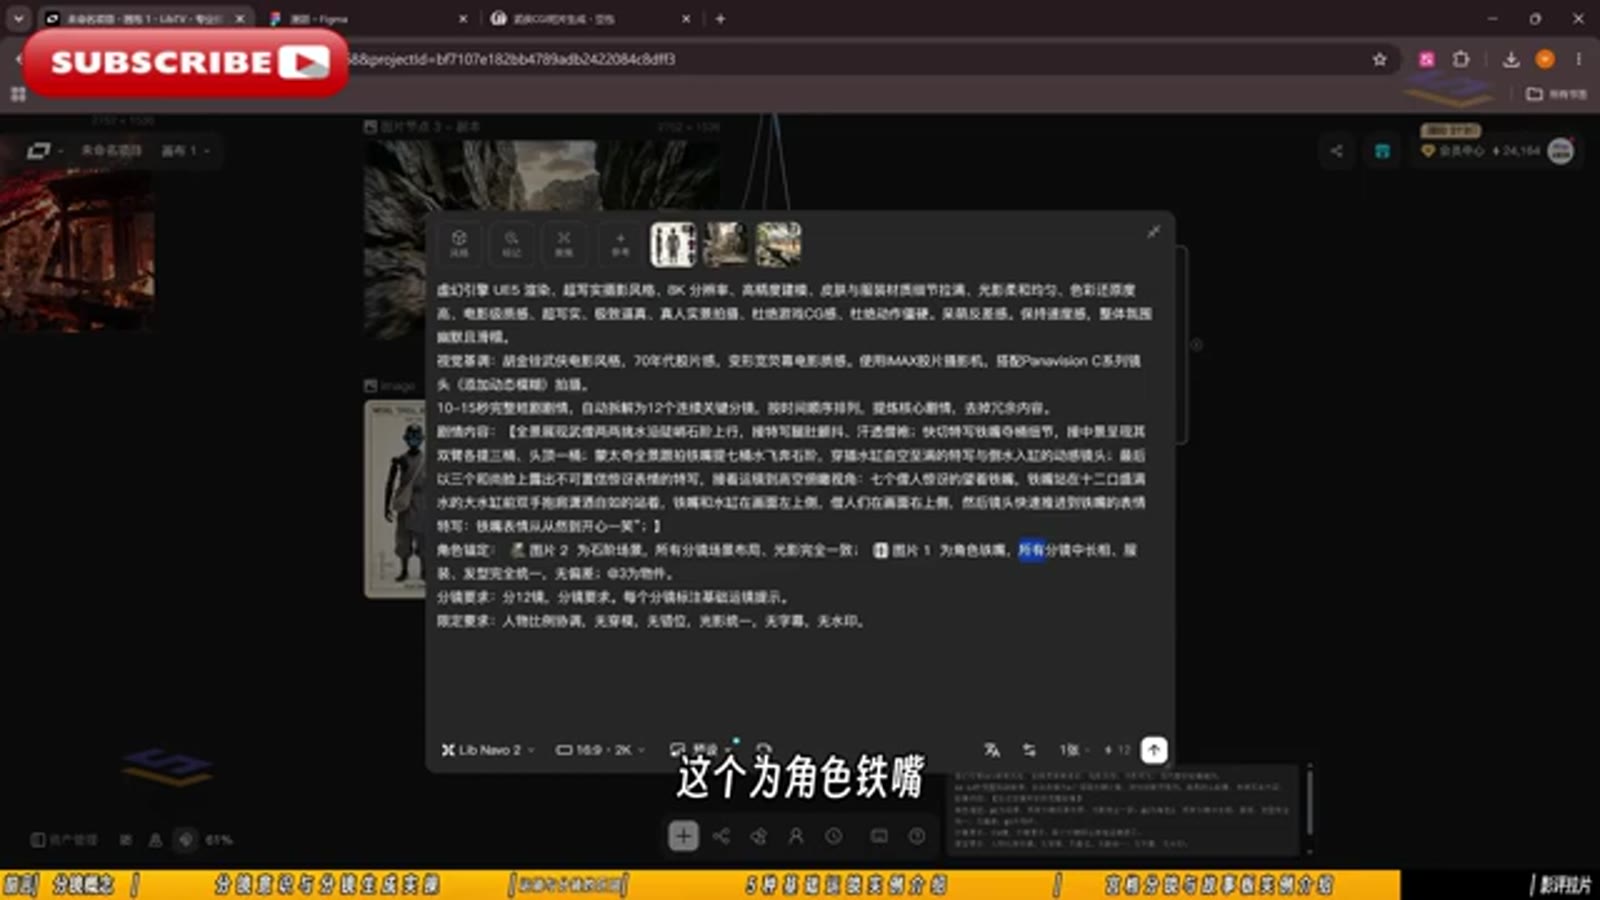
提示词里用编号引用参考图:【图像1】为角色铁嘴(外形/神态/表情/服装以图为准),【图像2】为场景——模型认图不认字,编号绑定是 LibTV 多图参考的用法核心。提示词结构照抄模板:分镜概述(第 N 镜,外景/内景)→ 画面内容 → 角色设定(引用图像编号)→ 限定要求(人物比例协调、发型服装保持一致)。
生成参数面板:
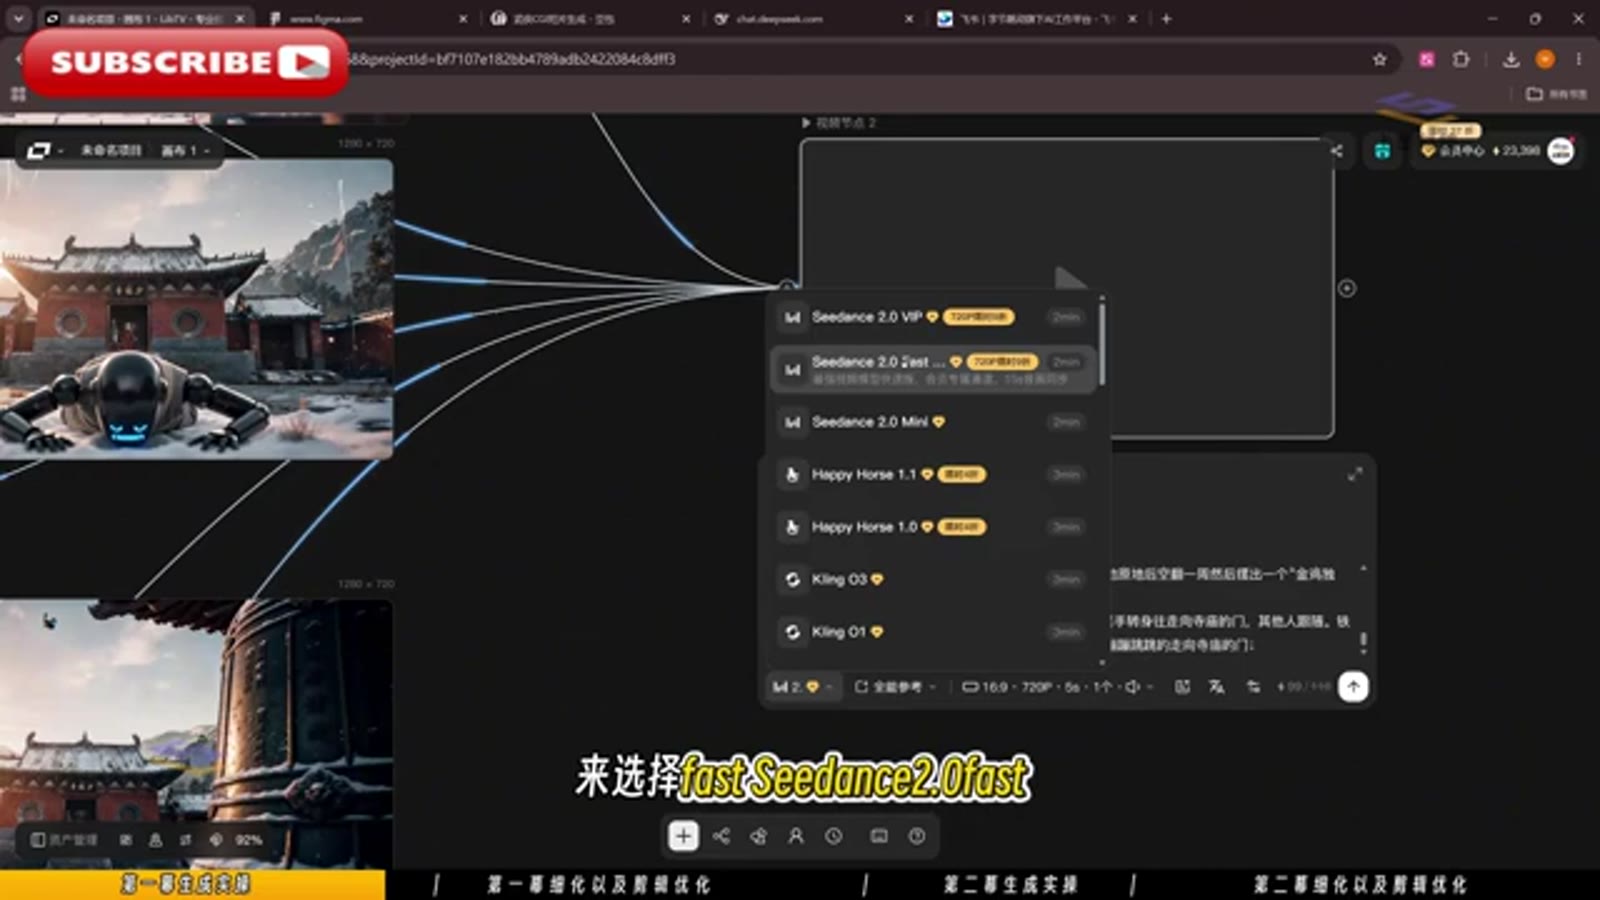
模型下拉可选 Seedance 2.0 VP / Fast / Mini、Happy Horse 1.1 / 1.0、Kling 03 / 01。教程的默认选择是 Seedance 2.0 Fast + 全图参考模式 + 16:9 + 720P + 6 秒 + 1 个。全图参考意味着所有挂载的参考图整体约束画面,这是多主体一致性的开关。
第八步:剪映收尾
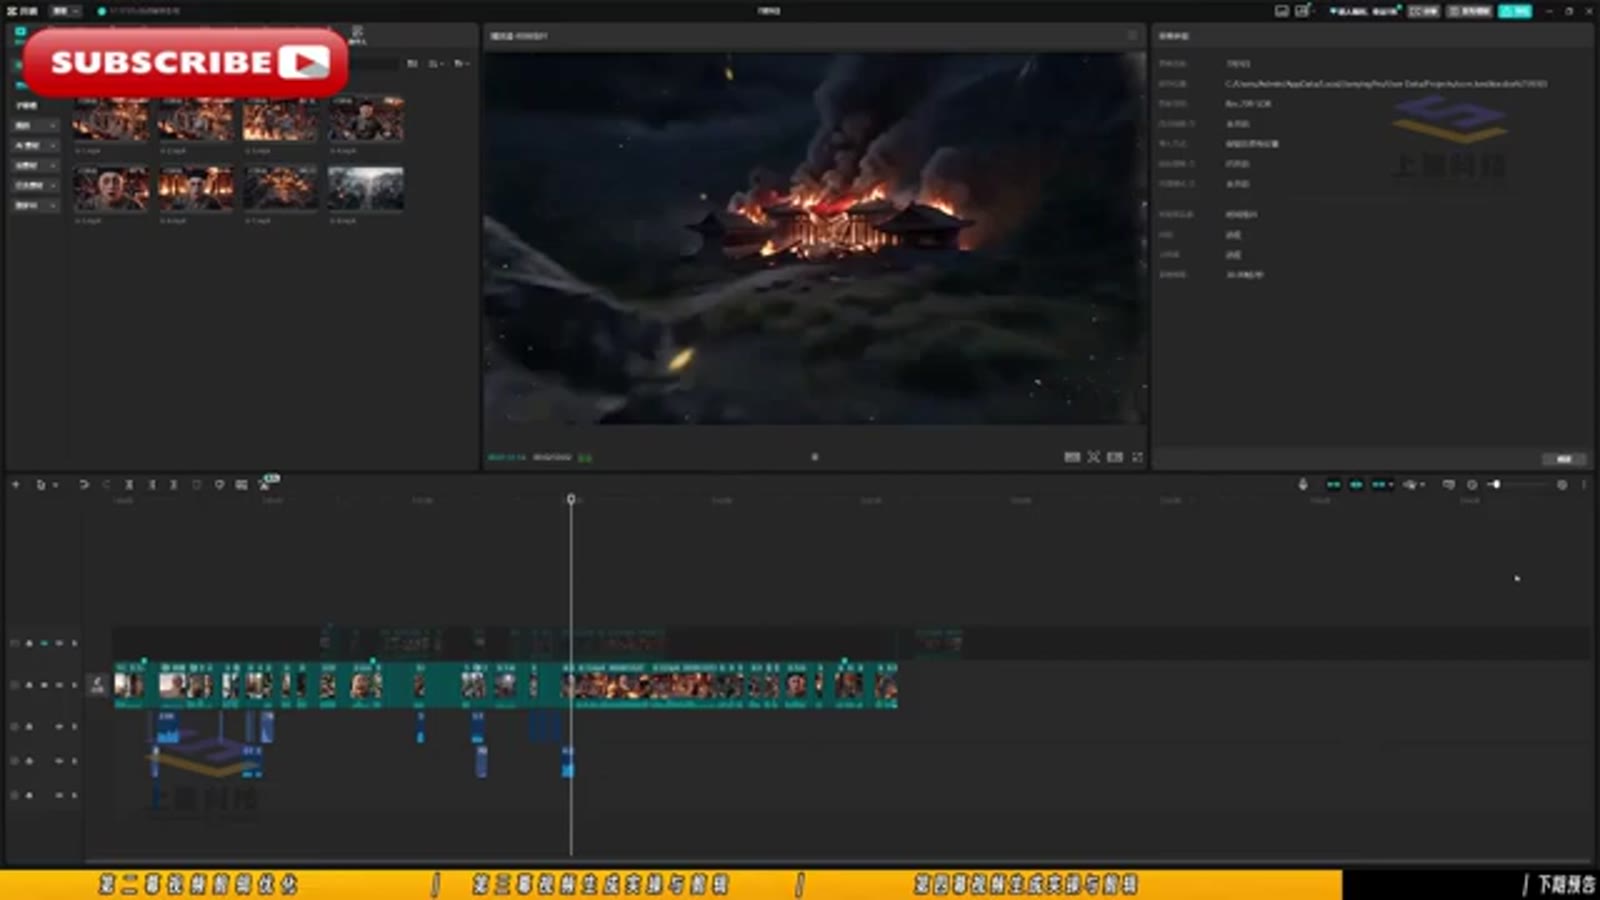
素材按分镜顺序铺进时间线,开头一个 0.5 秒黑屏"起手势”——短剧开场的呼吸感就是这么来的。
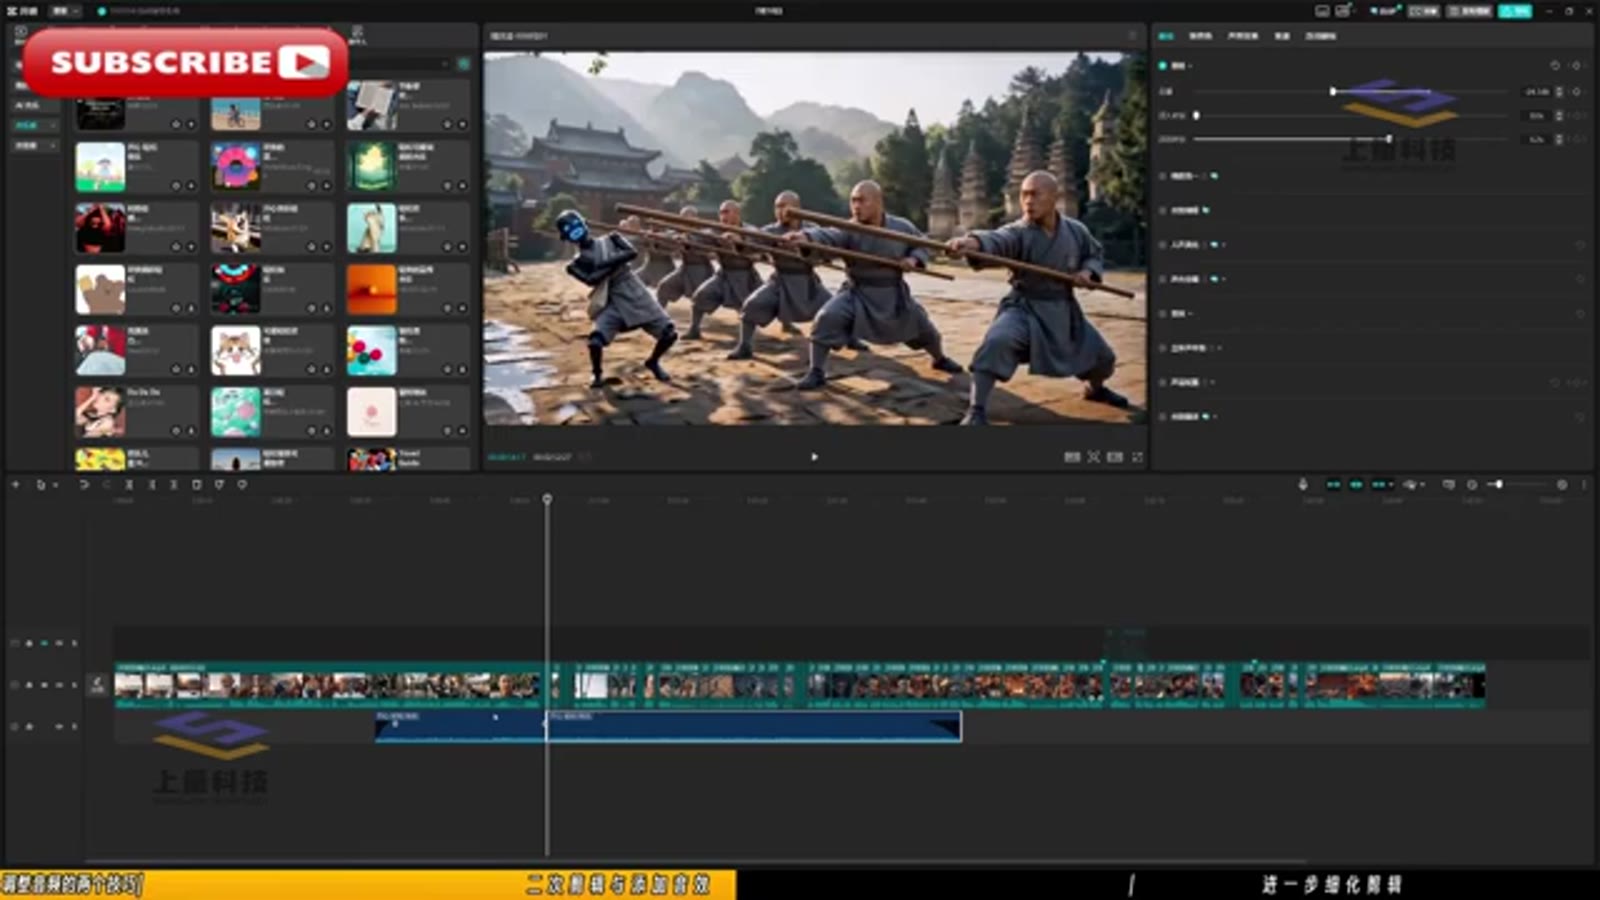
收尾三板斧:音效库补"人声以外的其他声音"(环境音、动作音)、音乐库选氛围 BGM 拉长轨道、设置音量与淡入淡出。字幕用剪映智能字幕识别配音再手动改错,教程的编剧注早写好了配乐方向:“蒸汽朋克舞曲切电子战斗风,温情钢琴收束”。
14 步速查表
| 步骤 | 动作 | 关键参数/模板 |
|---|---|---|
| 1 | 即梦+LibTV 环境熟悉 | 素材库搜参考视频 |
| 2 | AI 写剧本 | 3+3+3 法则提示词,分幕收敛 |
| 3 | 剧本拆分镜表 | 时间段/动作/推进/冲突 四列 |
| 4 | 道具+场景资产 | 产品图/空镜模板 + UE5 + 8K |
| 5 | 角色几何设计 | 圆方三角形状语言 |
| 6 | 角色三视图 | Lib Nawo 2,白底三视图 |
| 7 | 分镜画布 | 定场节点 + 节拍拆行 |
| 8 | RTCF 提示词 | 美学七要素显式写全 |
| 9 | 运镜语言 | 六种视角词写进提示词 |
| 10 | 视频提示词 | 图像编号引用绑定角色 |
| 11 | 生成参数 | Seedance 2.0 Fast + 全图参考 |
| 12 | 画幅设置 | 16:9 / 720P / 6s |
| 13 | 剪辑 | 0.5s 黑屏起手 + 分镜排序 |
| 14 | 声音包装 | 音效 + BGM + 淡入淡出 |
这套流程最反直觉的一点:生视频是第 11 步,不是第 1 步。 前十步全在做约束——剧本约束叙事,资产约束外观,分镜约束构图,提示词约束画面。Seedance 的"演技"只在约束铺满之后才兑现。
教程出处与成本账本见上一篇《〈首尔今天有点鲁〉为什么看着不假》。