
Agentic RAG 架构的三重跃迁:传统RAG的纠错进化史
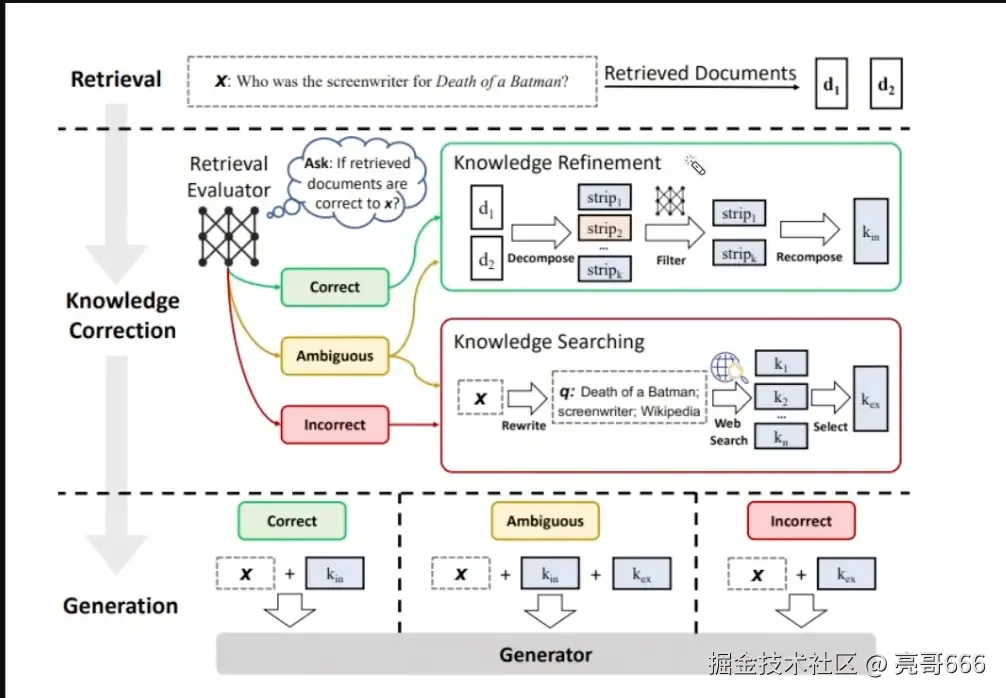
RAG(检索增强生成)技术在落地过程中面临三大共性痛点:盲目检索浪费算力、轻信低质文档导致幻觉、生成后缺乏自检机制。针对这些硬伤,业界逐步演化出三代Agentic RAG架构——基础检索自纠错、标准CRAG与带回环的Self-RAG。它们并非简单迭代,而是代表了系统设计思路上的根本性转变:从单向管道走向双向反思闭环。
核心差异可概括为:
- 方案一:本地循环重搜 —— 通过质检节点触发重检索,但存在本地盲区导致的死循环风险
- 方案二:双阈值兜底 —— 采用CORRECT/INCORRECT/AMBIGUOUS三档裁决,本地不足时自动调用网络搜索作为兜底
- 方案三:前置门控+产后双验 —— 查前审问省算力,材料安检去噪音,answers核查阻断幻觉,形成完整回环
基础检索自纠错:朴素循环的双刃剑
基础检索自纠错方案的设计逻辑极为朴素:“查完先质检,不合格就换个词重新搜本地”。其状态流转清晰可分为五步:用户提问后由智能体节点决策是否需要检索;执行本地向量检索;调用评估节点判断召回质量;合格则进入生成环节,不合格则触发查询改写节点后闭环重试。
该方案在局域网知识库完备的场景下表现良好,但存在两个工程硬伤:一旦本地知识库缺失相关内容,系统将在重试循环中无限空转直至超时崩溃;且缺乏外部数据源兜底手段,自愈能力极其有限。该方案最大缺陷在于只在本地知识库内打转,无法突破数据源边界。
标准CRAG:单向流水线的工业级解法
CRAG(Corrective RAG)通过"外援兜底"与"句子级降噪"的组合拳解决了知识盲区与长文档噪音问题。其核心创新在于双阈值三档裁决机制——设定高阈值0.7与低阈值0.3,根据文档得分将输入分为三类:
- 任意分块得分 > 0.7 → CORRECT verdict,直接启用本地合格文档
- 所有分块得分 < 0.3 → INCORRECT verdict,触发网络搜索兜底
- 0.3 ≤ 得分 ≤ 0.7 → AMBIGUOUS verdict,本地弱相关与网络结果混合补充
值得注意的是:CRAG彻底放弃反复重试的回环。单向无环拓扑结构使其耗时与成本完全可预期,never卡死在某个循环里,这在生产环境中被视作关键工程优势。
句子级粉碎去噪则是其另一核心。无论本地还是网络召回的材料,均被切分为独立句子后由专门小模型过滤。不相关废话直接丢弃,最终拼接的上下文极度纯净,从源头阻断大模型幻觉诱因。需要注意,生产环境必须对句子过滤器采用并发调用并选用极速小模型,否则串行处理将成为性能瓶颈。
Self-RAG:带前后哨兵的双向质检闭环
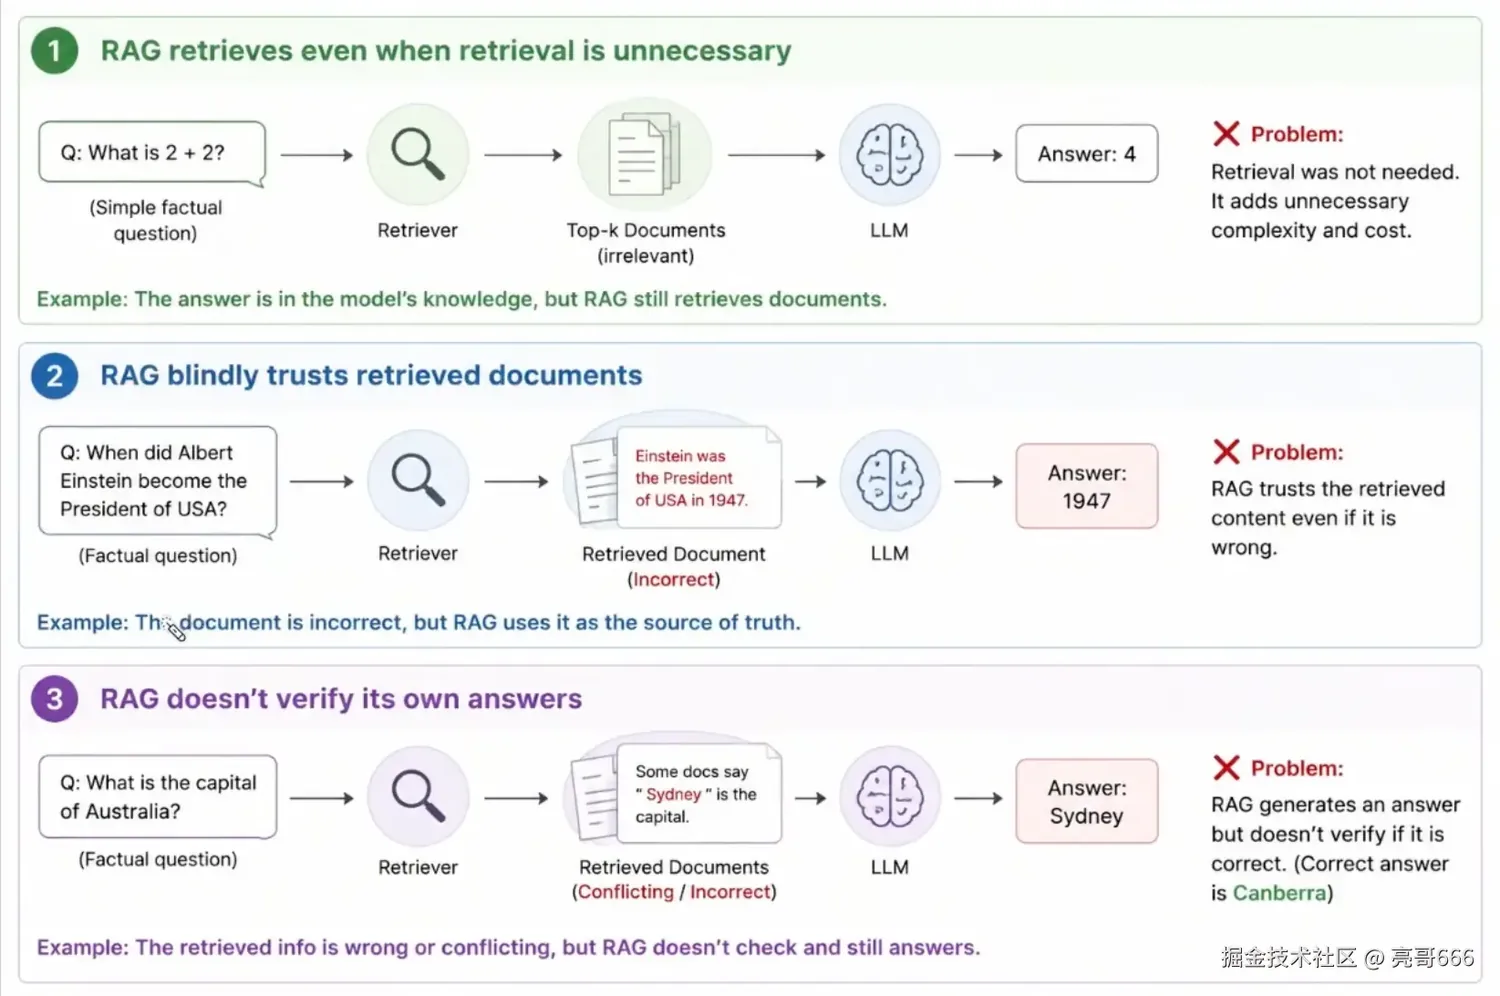
Self-RAG(自我反思检索增强检索)的提出直指传统RAG的三大经典硬伤:盲目检索、盲目轻信、答完不检查。其"3+1层安检灵魂"层层把关:
- 第1层(查前审问):前置decide_retrieval节点拯救算力。对2+2=?等常识题直接跳过检索,避免拼接无相关性的长上下文
- 第1.5层(材料安检):is_relevant节点逐篇审查召回文档,剔除"爱因斯坦当选美国总统"类恶搞噪音
- 第2层(产后核据):与第3层合并为audit_llm一次性调用,同步检验is_grounded(事实依据)与is_useful(切题程度)
- 第3层(切题检验):确保答案不跑题
工程杀手锏在于产后双验合一。使用Pydantic结构化输出一次调用完成两项检验,较论文拆分两次节省1-2秒首字延迟,并减少50%输入Token消耗。
该设计衍生出两套自纠错回路:
- 小闭环(微观):当is_useful通过但is_grounded失败时,触发revise_answer原地润色,无需重检索
- 大闭环(宏观):当is_useful失败时,触发rewrite_question重写问题回流重搜
选型建议与落地路径
适合快速落地的场景:知识库边界清晰且完备度高,推荐基础检索自纠错方案,实现成本最低。
适合生产环境的平衡方案:需要兼顾质量与成本的通用场景,标准CRAG是首选。单向拓扑保证响应可预期,双阈值机制天然适配大多数业务
适合高价值问答场景:金融、法律、医疗等对事实准确性要求严苛的领域,Self-RAG的双向质检闭环虽复杂但能最大程度抑制幻觉。尤其当答案错误代价高昂时,多出的工程复杂度是值得投入的。
写在最后
三代架构演进揭示了一个清晰趋势:RAG系统的可靠性越来越依赖其内部的元认知能力。从简单循环到复杂回环,本质是降低大模型盲目性与增强系统自检力的持续博弈。未来演进方向很可能是图幺化——将质检、改写、检索、生成等节点抽象为可编排的Agent图谱,而非固化流水线。