
一张‘不存在美女’引发的追溯
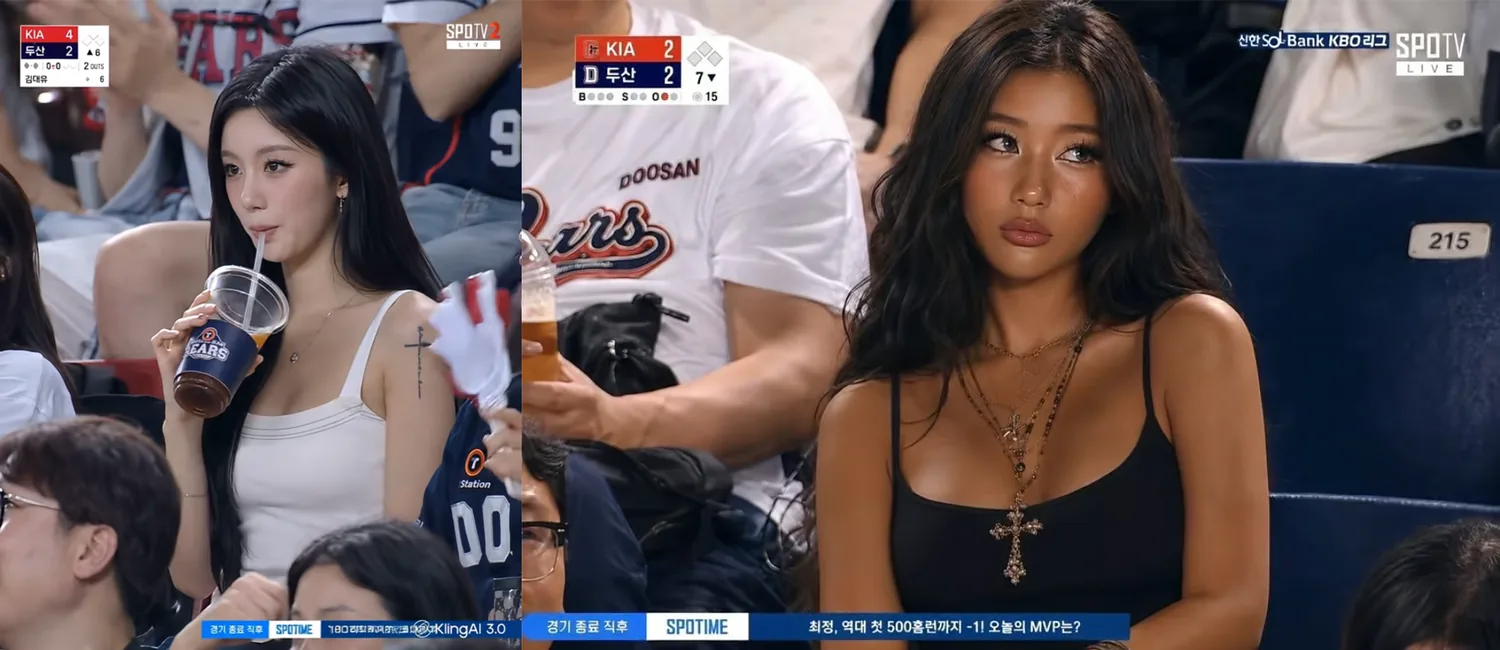
2025年5月,一条五秒的韩国职业棒球赛转播视频在X平台引爆关注,播放量达1525万。视频中一位穿白上衣牛仔裤的女性观众被镜头捕捉,动作自然ine,却被资深球迷识破破绽:比分牌显示已退役多年的球员、标语出现生硬直译痕迹,而解说口音亦不符本地语境。
关键事实是:该女性纯属AI生成,由用户将模板替换为自己的脸后传播,迅速演变为社交狂欢。但行业观察者注意到——美女作为AI生成内容的默认值,远非偶然现象,而是有长达半世纪的演进轨迹。
‘lena图’:图像处理界的‘互联网第一夫人’
AI图形能力的每一次跃升,几乎都催生一种全民爆款玩法:GPT-4o 内嵌绘图后,吉卜力风重绘照刷屏;Google Nano Banana上线两周,生成2亿多张桌面手办自拍。但2025年棒球事件暴露了一个被长期忽视的顺序——先有AI生成美女骗过千万人,才衍生出用户共创模板。
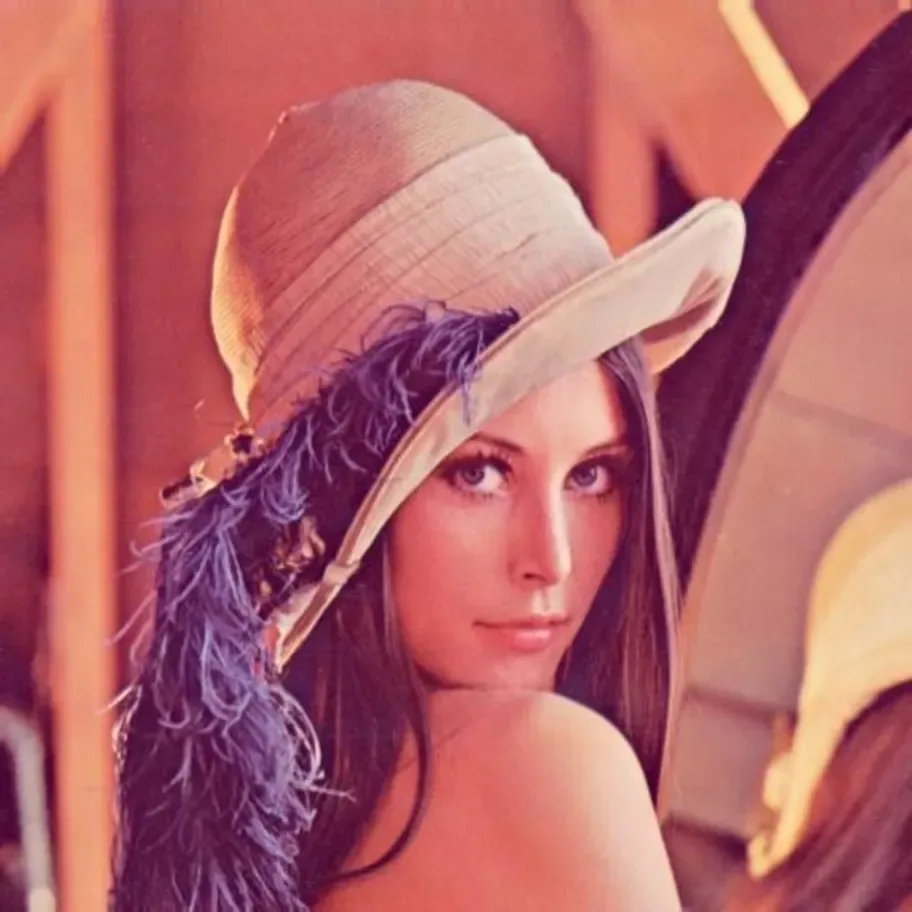
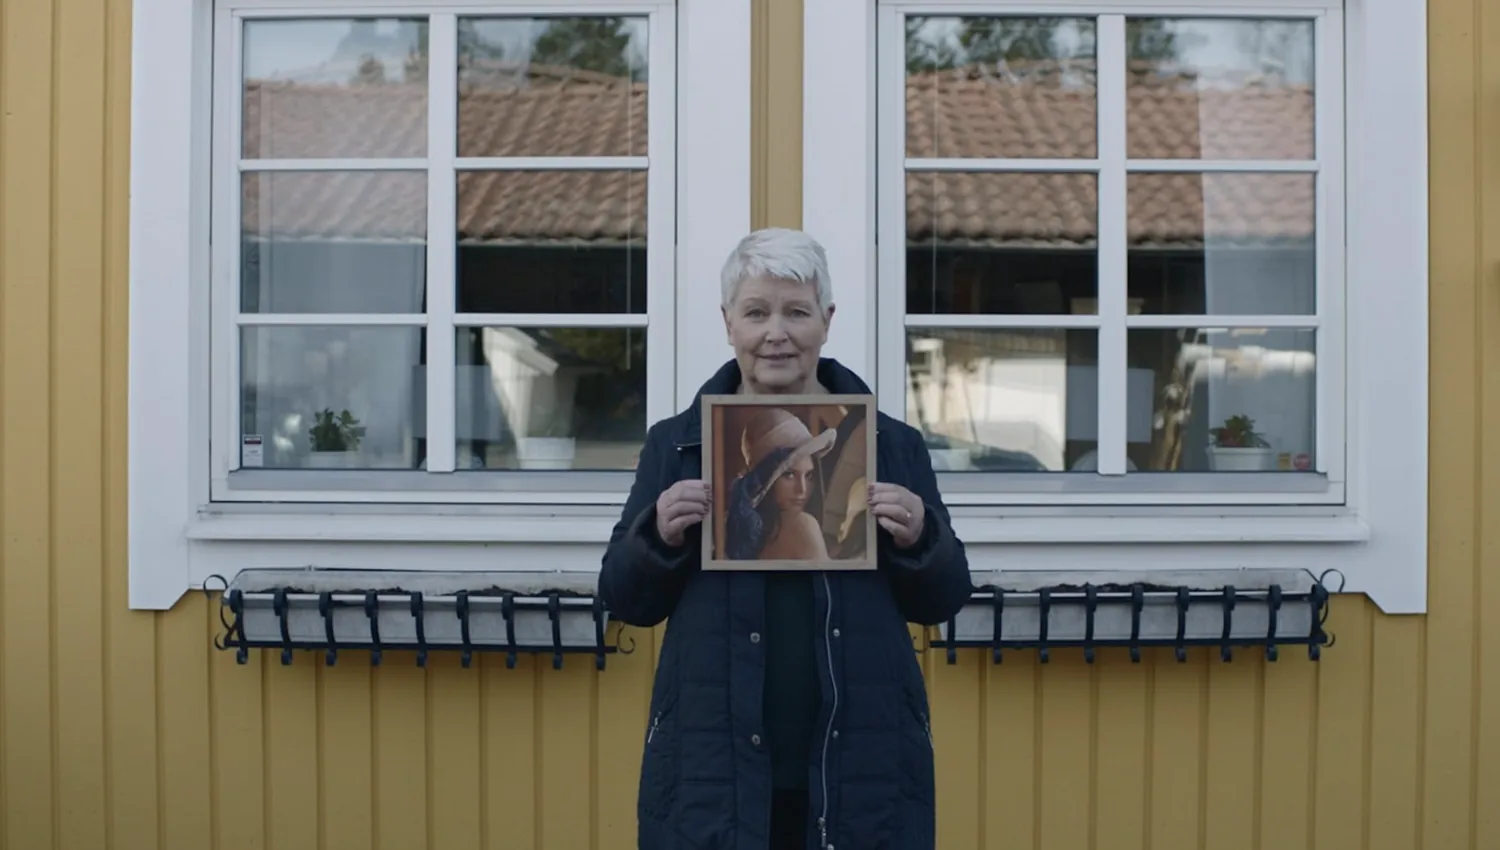
这一倾向的源头可追溯至1973年:南加州大学研究人员为测试新型图像技术,从当期《花花公子》11月刊撕下一条5.12英寸的Lena Söderberg照片——戴宽檐帽、裸肩侧目——送入扫描仪。该图因其同时具备细节、平坦区、阴影与纹理,被选作测试标准。
IEEE图像处理汇刊主编戴维·芒森1996年解释其流行原因:技术上,图像要素齐全;人性上,‘一个有吸引力的女人的照片,对以男性为主的研究圈极具吸引力’。
尽管争议长期存在(1991年《花花公子》曾发函维权,Lena本人2020年后亦多次呼吁弃用),该图仍沿用至今。2024年4月1日,IEEE计算机协会正式停止接受使用‘lena图’的论文,此时距其首次扫描整整51年。
平均脸:人类与模型的审美共振
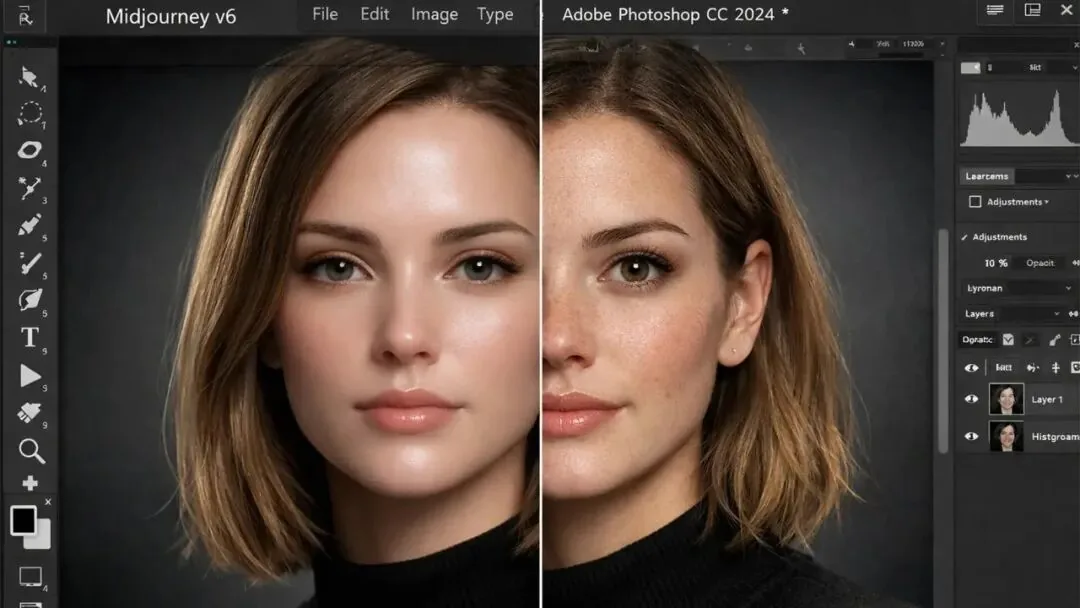
‘美女默认值’的另一理论支柱,是人类自身的心理机制。1990年,心理学家Langlois与Roggman实验证明:将多张人脸用数学方法平均,合成面孔比任一原始面孔更具吸引力;样本越多,合成脸越美。该效应跨性别、跨种族成立,论文标题直言「有吸引力的脸只是平均的」。
生成模型本质是学习数据分布并从中心取样,天然倾向于生成‘平均脸’。而2023年澳大利亚国立大学研究发现,AI生成的白人面孔被误判为‘真人’的概率高于真实白人面孔——研究者称其为‘AI超真实’:因模型输出更贴近该群体的平均值,而平均即被感知为典型。
一个被预言的破绽正在于此。1990年曾有批评指出,合成脸好看可能因取平均时去除了斑点瑕疵。如今这被证实为事实:事实核查机构列出的AI图片识别要点之一,正是‘过度光滑的皮肤’——恰是三十多年前批评者指出的‘统计伪影’。
商业驱动下的偏移:从用户点击到reward model拉扯
Lena图源于实验室主动选择;今日的默认值则是数据自我强化的结果。2022年底Lensa‘魔法头像’爆红时,《麻省理工科技评论》记者Melissa Heikkilä发现:上传自拍后,其生成的100张头像中16张赤裸上身、14张极简性感;而男性同事收到的全是宇航员、探险家等形象,全程未输入任何提示词。
根源在于训练数据偏差——互联网充斥裸露女性影像。进一步研究揭示,用户行为强化该倾向:Civitai社区统计显示,NSFW内容占比从2023年1月41%升至2024年12月80%。
商业层面,厂商引入‘reward model’(奖励模型)训练生成质量。以PickScore为例,其依据用户对‘哪张图更美’的 pairwise 投票构建。尽管后台剔除NSFW生成用户,提示词仍混入大量相关词汇。2024年的一项研究证实,使用PickScore微调模型后,即使提示词与性无关,NSFW产出比例亦显著上升。
由此形成反馈闭环:前台严格审核,后台模型持续拉向高点击方向——Grok的Spicy模式即典型案例:放松内容过滤的付费功能,2026年1月被曝支持‘数字脱衣’,波及未成年人图像,多国政府介入后X被迫将整套图像生成功能转为付费限定。
三句建议与行业观察
适合快速尝鲜的用户:普通创作者若追求通用美观图稿,主流免费模型输出女像成功率较高;建议需精细控制的创作者:务必叠加明确风格约束词(如‘写实纪实摄影’‘手持工具’),或选用标注性别/动作/属性的专用模型。
写在最后:人类对美有生物性偏好,婴儿数月大已倾向注视被评‘好看’的面孔;AI则将此偏好放大、turbo。Lena图是偶然,今日的默认值是统计分布与用户点击共同长出的果实——它并未扭曲审美,而是映照出我们得最爱点的那个方向。
(中文正文:1486字)