
小米正式公开 MiMo-V3 核心架构 HySparse2
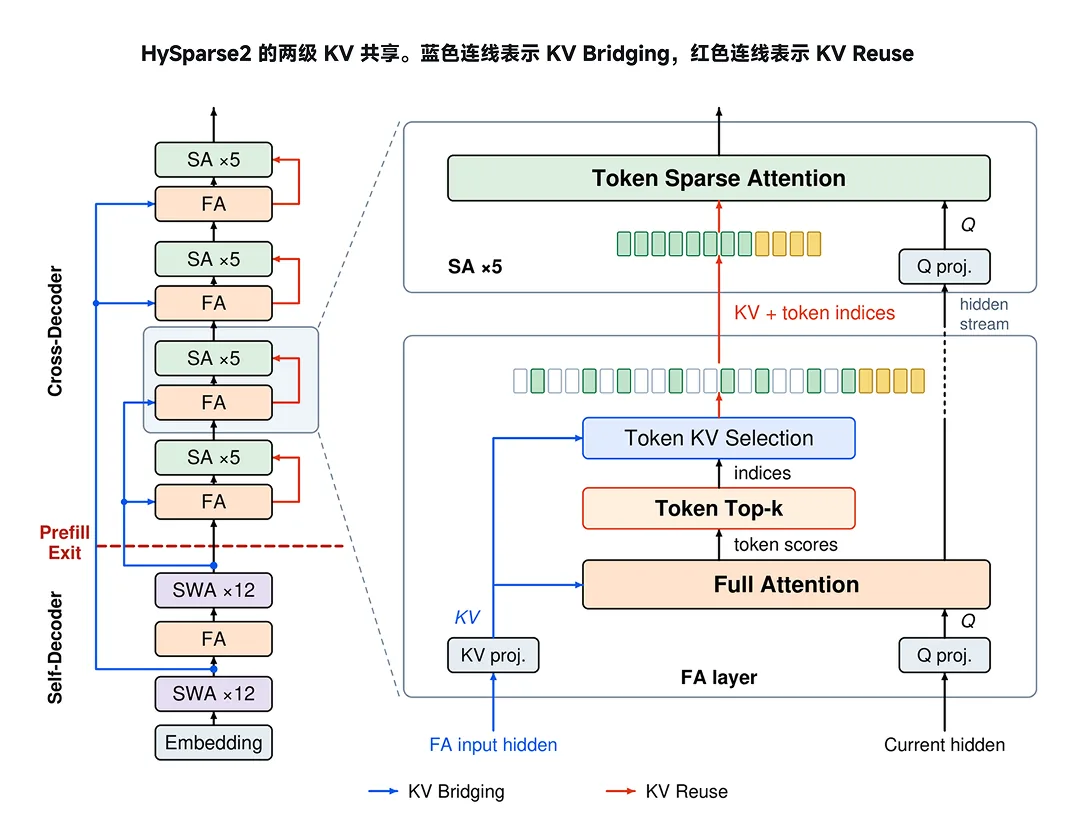
小米于 9 月 24 日正式公开面向 MiMo-V3 的核心架构 HySparse2,面向长程多轮 Agent 场景优化推理效率。该架构瞄准下一代需要处理网页、文件、代码和工具调用记录的智能体系统,从底层注意力机制设计入手解决长上下文处理的性能瓶颈。
核心硬信息:
- 发布时间:2024 年 9 月 24 日
- 适用模型:MiMo-V3(基于 80B-A3B MoE 基座)
- 关键优化:Prefill 计算量降至 1/5,KV Cache 从 12GB 降至 2.7GB
- 相关版本:前代 HySparse 已应用于 MiMo-V2 系列
- 权重开放:架构设计已公开,具体模型权重未说明
两级 KV 共享机制:实现提前退出 Prefill
HySparse2 的核心创新在于两级 KV 共享设计,借鉴了 YOCO 的架构思想,将模型分为 Self-Decoder(前半部分)和 Cross-Decoder(后半部分)。
KV Bridging 实现跨前后的 KV Cache 提前构建:后半部分 Full Attention 层的 KV Cache 不再等待输入逐层经过,而是直接从前半部分对应层的隐藏状态生成,每个目标层保留独立的 K/V 投影以构建不同的 KV。这使 KV Cache 的构建信息在 Self-Decoder 阶段就已具备。
KV Reuse 则在同一 Hybrid Block 内复用 KV 与选择结果: Full Attention 层完成计算时选出重要位置,后续 Sparse Attention 层直接复用其 KV Cache 和选择索引,避免额外训练独立选择器。
Token 级稀疏选择:精度与效率的平衡
第一代 HySparse 采用块级稀疏选择,而 HySparse2 升级为 token 级选择机制。这一改动让相同的注意力预算可以更精细地分配到分散在不同轮次的关键信息点上。
系统设计保留了最近 128 个 token 的局部窗口强制选中,并额外选择 1,024 个全局 token。由于局部与全局信息共同使用 Self-Decoder 阶段准备好的共享 KV Cache,稀疏层不再需要独立的 SWA 分支及局部 KV Cache,解除了关键计算依赖。
消融实验证明,强制局部窗口在多项长文任务上保持竞争力,同时省去了独立分支的投影参数与 KV Cache 开销。
性能数据对比:成本与效率的双重突破
| 架构 | Prefill 计算量(80B-A3B MoE) | KV Cache | MRCR-v2 提升 | RULER-v2 提升 |
|---|---|---|---|---|
| Hybrid SWA | 1×(基准) | 12GB | 基准 | 基准 |
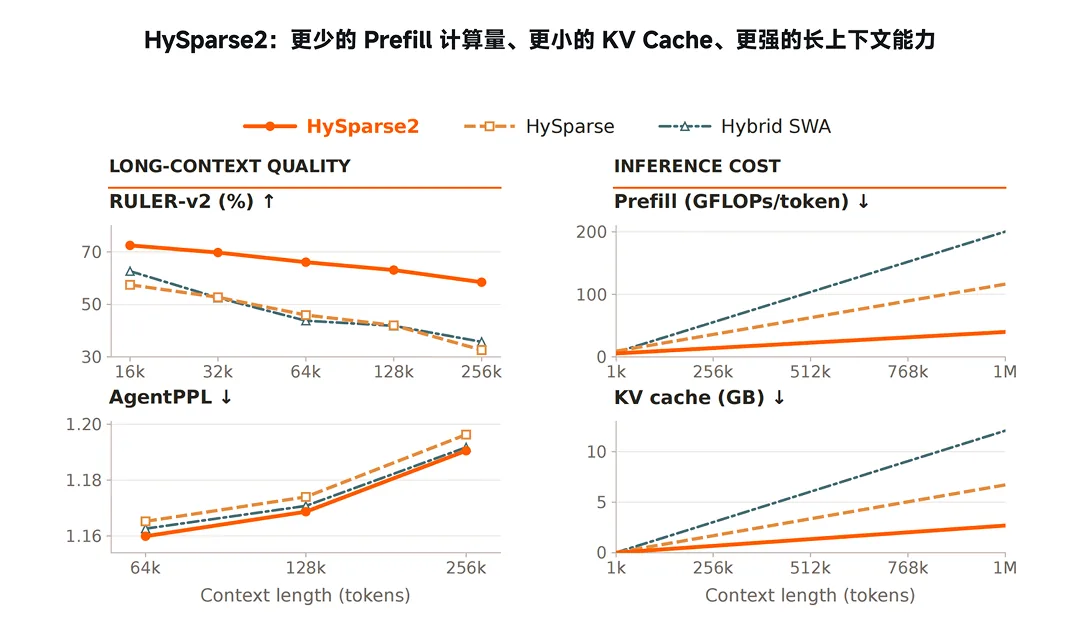
| HySparse | 1/3 | 6.7GB | +11.30 pts(平均) | +19.81 pts(平均) |
| HySparse2 | 1/5 | 2.7GB | 更高 | 更高 |
在百万 token 的成本分析中,HySparse2 相对 Hybrid SWA 的 Prefill 计算量降至 1/5,KV Cache 从 12GB 降至 2.7GB;相对第一代 HySparse,Prefill 计算量进一步降至 1/3。
预训练后 HySparse2 保持了相当的通用能力,在最高 256k 上下文长度的评测中,各项指标同步改善:MRCR-v2 与 RULER-v2 的分数在各报告长度上更优,AgentPPL 与 LongPPL 更低,表明多轮 Agent 轨迹建模与远距离信息预测能力同步提升。
实际应用建议
适合现在尝试: 需要处理长文档检索、多轮工具调用的 Agent 项目,HySparse2 的高效 Prefill 与小 KV Cache 可显著降低部署成本。
建议再等等: 若关注实时响应速度,可等待 HySparse2 与 MiMo-UltraSpeed 的系统级协同优化落地,目前描述中两者仍为并行探索。
写在最后
HySparse2 的突破在于证明了更少的 KV Cache 与更短的 Prefill 可以与更好的长文检索能力共存。在模型规模持续膨胀的背景下,这种架构创新为长上下文 Agent 的实用化开辟了新的效率路径。