核心事件速览
9 月 17 日,智谱 GLM 团队正式披露递归自我改进(Recursive Self-Improvement, RSI)方向首个工程化实践成果。这是国内大模型厂商首次公开将 AI 自我改进能力部署至生产环境。
- 技术主体:由 GLM-5.3 驱动的 Infra Agent
- 改进对象:GLM-5.3-Flash 推理基础设施
- 部署平台:超 10 万张国产芯片组成的集群
- 工程成果:从零构建生产级推理服务,端到端吞吐提升至基线 3 倍
- 上线表现:以匿名模型 Ox-Alpha 在 OpenCode、OpenRouter 上线,6 天 Token 调用量超 62 万亿
- 系统状态:已投入真实使用,非实验性原型
技术细节与关键突破
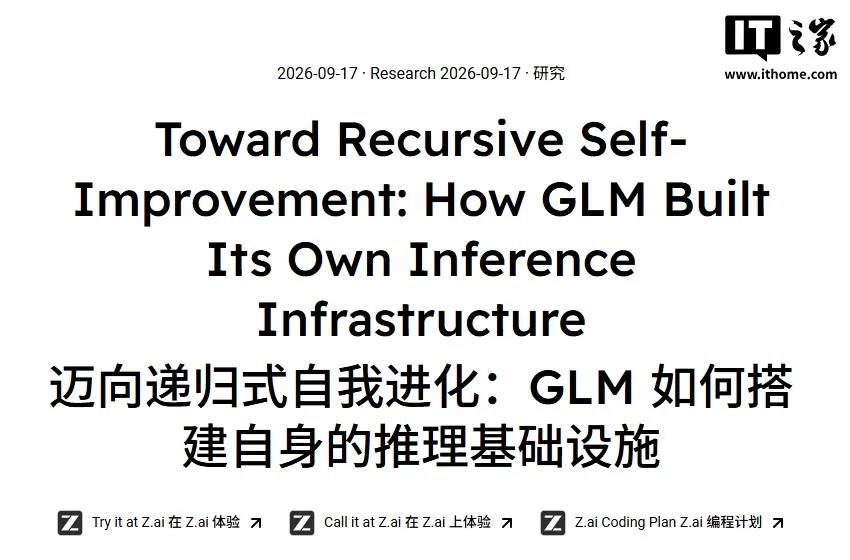
递归自我改进(RSI)指 AI 模型在运行过程中能够识别系统瓶颈,并自主完成代码编写、调试与性能优化,形成‘感知-决策-执行-反馈’的完整工程闭环。本次实践中,Infra Agent 并非仅生成代码片段,而是全过程主导了推理服务基建的构建与迭代。
值得注意的是,原系统采用的推理模型为 GLM-5.3-Flash,而驱动改进工作的模型为 GLM-5.3——即后者作为‘工程师’前向改进前者的运行环境,形成一次‘模型改进自身下游版本’的反向操作。 \n系统在短短不到两周内,将端到端吞吐 performance 提升至初始基线的 3 倍,硬件利用效率与单 Token 成本达到与主流 NVIDIA GPU 相当水平。
这一进展打破了以往大模型仅作为’代码生成工具‘的局限,使其真正参与并主导基础设施层的完整工程链路,包括架构设计、性能调优与稳定性验证等环节。Infra Agent 的推理调度逻辑与服务部署脚本,均由其自身动态生成并持续迭代,无需人工代码审查介入。
产品与平台对比
本次信息披露未提供具体性能参数对比表格,但明确提及硬件利用效率与单 Token 成本达到主流 NVIDIA GPU 水平。根据已知事实整理如下:
| 维度 | Infra Agent 实现结果 | 官方基准表述 |
|---|---|---|
| 硬件平台 | 超 10 万张国产芯片集群 | 国产芯片,型号未披露 |
| 端到端吞吐 | 初始基线的 3 倍 | 不到两周达成 |
| 单 Token 成本 | 与 NVIDIA GPU 相当 | 官方博客披露 |
| 硬件利用效率 | 达到 NVIDIA GPU 水平 | 官方博客披露 |
| 上线响应时间 | 6 天调用量 > 62 万亿 Tokens | OpenCode / OpenRouter |
需说明,表格中‘国产芯片’及具体型号未在原文中披露,仅保留客观属性描述。
读者落地建议
- 适合立即尝试者:对推理成本敏感、需频繁迭代服务性能的中大型 AI 应用团队;已有国产芯片集群基础设施的机构,可关注智谱后续 API 或 SDK 落地适配方案。
- 建议继续观望者:期待开放 Web 界面或精细控制台的企业用户;需要国产芯片型号、驱动版本、调度策略等工程细节的深度技术团队,目前信息尚未公开。
目前系统以匿名模型 Ox-Alpha 形式对外提供服务,暂未开放 GLM-5.3 的在线调用接口或 Agent 接口文档,第三方开发者尚无法直接接入 Infra Agent 的自我改进流程,仅能通过调用已部署的 Ox-Alpha 接收服务。如计划采购相关技术服务,建议关注智谱后续开源计划或企业级合作白皮书。
写在最后
此次工程化落地表明,大模型的自我改进能力已从理论构想进入实际基建优化阶段。当 AI 不再只写代码,而是直接管理代码运行的‘土壤’,模型迭代的边界将持续前移——从单纯提升精度,延展至提升自身运行效率。这是大模型工程成熟度的一个标志性拐点。