
核心事件
智谱于2026年9月16日面向投资者召开电话沟通会,披露其在 Infra 层面落地 RSI(Recursive System Improvement,递归式系统优化)的战略进展。相关系统已实际支撑 GLM-5.3-Flash(即匿名模型 Ox-Alpha)在国产芯片集群上稳定运行:
- 发布时间:系统已上线,真实生产流量切换完成时间为9月上旬
- 支持规模:10万张国产芯片集群
- 实际成效:6天内处理超62万亿 Token;端到端吞吐量提升3.2倍
- 部署周期:全链路从首次跑通到全量切流仅耗时两周
- 技术载体:GLM-5.3 驱动的 Infra Agent 作为系统底座
关键事实与反差数据
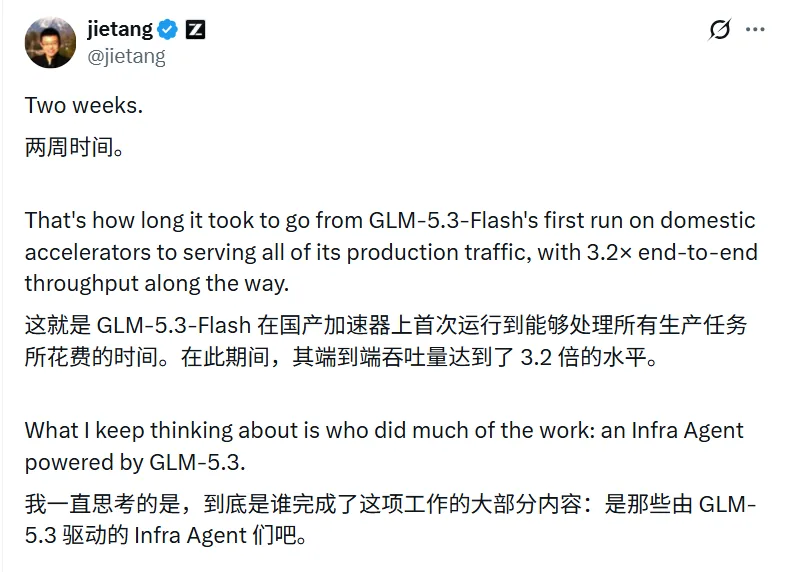
智谱此次 Infra 升级面临三重行业级挑战。首先,国产芯片在内存带宽与数据传输速率上天然不及英伟达方案,传统优化路径无法直接套用;其次,底层软件栈极不成熟,大量关键算子缺失,底层文档需要工程师“反向推测验证”;第三,GLM-5.3-Flash 采用全新架构,支持图文多模态及100万 token 超长上下文,KV 缓存压力呈几何级增长。
最显著的反差在于:部署周期。过去此类规模的基础设施切换通常需资深团队数周至数月完成,而智谱仅用两周。其核心解法是通过 Infra Agent 以“软件补丁”弥补硬件短板——例如用通信换内存(节点内张量并行+层分割)、用计算换内存(ReplaySSM 策略)、用精度换容量(W8A8 量化 + KV 缓存动态多精度混用),以及彻底解耦编码、预填充、解码三阶段以换取调度自由度。
更值得观察的是“稀疏反馈”问题。传统推理系统仅在出错时返回笼统指标(如“吞吐量下降20%”),但无法定位根因。智谱构建的“密集反馈”分层验证体系将问题拆解为三类:正确性反馈(算得对不对)、系统行为反馈(卡在哪一步)、性能反馈(哪种解最优),从而让 AI 具备类资深工程师的工程直觉。
分层验证体系实战案例
案例一:长上下文精度漂移。AI 识别出 KDA 内核默认精度导致舍入误差累积,自动匹配开源经验库方案,将计算显式升级为更高精度组合算法。
案例二:Prefill 阶段并发瓶颈。系统自动拉取全链路时序图,跨 Python/C++ 语言边界检查 GIL 锁状态,定位通信线程被卡死问题,排障时间从数天缩短至数秒。
案例三:解码内核性能优化。借助“优化模板库”(源自 SGLang、Flash Linear Attention、DeepGEMM 等项目提炼的通用骨架),AI 快速匹配并套用 Tiling 等优化模式,闭环迭代后反哺模板库增强自身能力。
为何 Infra 成为战略重心?
据内部电话会透露,智谱核心增长约束即为算力供给能力。2026年2月 GLM-5 发布后,调用量瞬时暴增10倍,直接迫使“Coding Plan”服务紧急停售半年。40亿美元融资到账后,该服务于7月重启,销量增幅超15倍,印证“有多少算力,就有多少收入”的逻辑。
智谱测算显示:若前期饱和投入300亿元算力(40%训练+60%推理),凭借 GLM-5.3 高达80%的推理毛利率,一年即可收回成本。为此其策略聚焦于:构建1GW级超算中心(自主可控)+全国产芯片部署 + 云分成模式(轻资产变现)。目前已与国内外多家云厂商签署 GLM 系列开源模型的收入分成协议,10月起正式确认收入。
读者建议
- 适合谁用:对国产算力有强依赖的企业客户(如政务、金融、 telecom 运营商)可优先评估;需要超长上下文处理(如金融报告、法律文书)且对成本敏感的团队;
- 建议再等等:若对推理延迟极端敏感(如高频 trading 系统)或依赖特定外部硬件生态(如 H100/V100 专属工具链),建议观察后续版本稳定性表现后再决策。
写在最后
智谱将模型能力与系统工程深度耦合,标志着大模型竞争正从“单点算力竞赛”转向“软硬协同优化能力比拼”。RSI 若能持续扩大反射弧复利效应,或将重塑中国 AGI 突破路径。